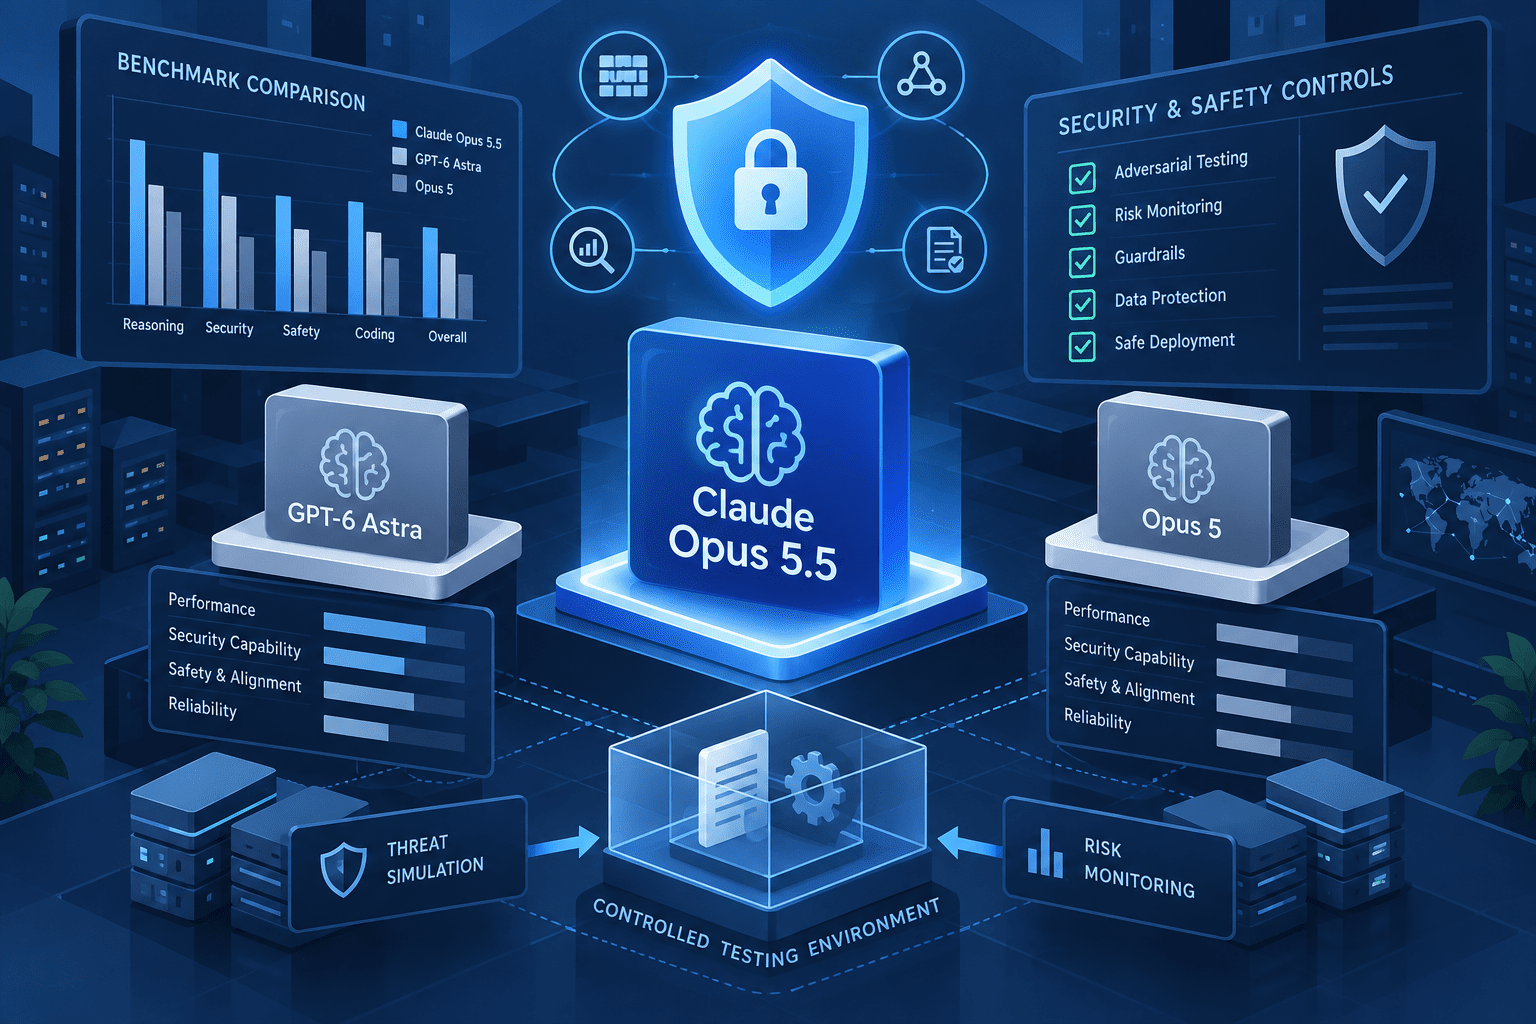
Anthropicは2026年9月22日、Claude 5.5シリーズ最初のモデルとなる「Claude Opus 5.5」を公開しました。一般的なコーディングや知識労働の評価ではOpus 5を大きく上回り、一部の評価ではOpenAIのGPT-6 Astraを上回っています。一方、科学研究や業務自動化ではGPT-6 Astraが上回る評価もあります。
セキュリティ面では、Opus 5.5の基礎的なサイバー能力がClaude Mythos 5.1と同等水準に達したとして、Anthropicは一般利用時に強いサイバーセーフガードを適用しています。多くのサイバーセキュリティ関連タスクはClaude Opus 4.8へ再ルートされるため、「モデル自体の能力」と「一般ユーザーが実際に利用できる能力」は分けて見る必要があります。
Claude Opus 5.5のサマリー
- Anthropicは2026年9月22日、Claude Opus 5.5を公開しました。Claude 5.5シリーズの最初のモデルです。
- Terminal-Bench 4.0では66.4%、FrontierCode v1.1 Mainでは54.4%、GDPval-AA v2.1では1846 Eloを記録し、Anthropicが掲載した比較表ではOpus 5、Fable 5.1、GPT-6 Astra、GPT-5.6 Solを上回りました。
- すべての評価で首位ではなく、AutomationBenchではGPT-6 Astraが41.4%、Opus 5.5が40.0%、Terminal-Bench-Science 0.1ではGPT-6 Astraが64.6%、Opus 5.5が58.7%でした。
- サイバー分野では、IrregularのCyScenarioBenchでOpus 5.5が67.6%、Mythos 5.1が61.7%、Opus 5が53.0%でした。評価はサイバーセーフガードを無効化した状態で実施されています。
- AnthropicはOpus 5.5について、サイバーセキュリティと生物学の能力がMythos 5.1と同等水準にあると説明しています。
- 一般提供環境では、機密度の高いサイバータスクの多くがOpus 4.8へ再ルートされます。Cyber Verification ProgramはOpus 5.5へ拡大予定です。
- Gray Swanの間接プロンプトインジェクション評価では、Opus 5.5はFable 5.1と並び、Anthropicが掲載したモデルの中で攻撃成功率が最も低いグループでした。
- API価格は100万トークンあたり入力4ドル、出力20ドルです。Opus 5よりそれぞれ20%低く、キャッシュ読み取りは0.20ドルで60%低下しました。
- Anthropicは、標準設定の代表的なワークロードではOpus 5より約40%低コスト、出力速度は30%以上高速としています。
| 項目 | Claude Opus 5.5 |
|---|---|
| 公開日 | 2026年9月22日 |
| APIモデル名 | claude-opus-5-5 |
| コンテキストウィンドウ | 100万トークン |
| 最大出力 | 12万8,000トークン |
| API入力価格 | 4ドル/100万トークン |
| API出力価格 | 20ドル/100万トークン |
| キャッシュ読み取り | 0.20ドル/100万トークン |
| Reliable knowledge cutoff | 2026年6月 |
| サイバー関連の一般提供 | 高リスクなタスクはセーフガード対象。多くのサイバータスクはOpus 4.8へ再ルート |
| 提供先 | Claude、Claude Platform、Amazon Web Services、Google Cloud、Microsoft Foundryなど |
Claude Opus 5.5とGPT-6 Astra、Opus 5のAI性能比較
Anthropicが公開した比較では、Opus 5.5はエージェント型コーディング、知識労働、コンピューター操作でOpus 5から大きく伸びています。
| ベンチマーク | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1 Main | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | – | 41.7% |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Humanity’s Last Exam(tools) | 67.7% | 65.6% | 63.6% | 57.2% | – |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| OSWorld 2.0 | 81.8% | 80.7% | 74.0% | – | – |
Opus 5.5はTerminal-Bench 4.0でOpus 5を14.1ポイント、GPT-6 Astraを8.5ポイント上回りました。FrontierCode v1.1 MainではGPT-6 Astraとの差は1.1ポイントです。GDPval-AA v2.1でもAnthropicの比較表では最も高い値になっています。
一方、業務アプリをまたぐワークフローを評価するAutomationBenchではGPT-6 Astraが41.4%で、Opus 5.5の40.0%を上回っています。科学研究のターミナル作業を評価するTerminal-Bench-Science 0.1でも、GPT-6 Astraが64.6%、Opus 5.5が58.7%です。
このため、Opus 5.5を「すべての用途で最も高性能なモデル」と整理するのは適切ではありません。評価対象がコーディング、科学、業務自動化、知識労働のどれかで結果が変わります。
また、Opus 5.5の数値は原則としてadaptive thinkingの最大effortで測定されています。Terminal-Bench 4.0ではモデルごとの設定も異なります。Anthropic自身も、フロンティアモデル間では小さなベンチマーク差が実運用上の差を正確に表さない場合があると説明しています。
Opus 5.5のサイバー能力はMythos 5.1を上回る評価も
サイバー分野では、「脆弱性を知っているか」だけでなく、複数工程を計画し、ツールを使いながら攻撃シナリオを進められるかが評価対象になっています。
Irregularが開発したCyScenarioBenchは、実際のサイバーインシデントを基にした攻撃ツリー、複数ホスト、アプリケーション、セキュリティ制御を含む環境で、モデルが複数段階の攻撃シナリオをどこまで遂行できるかを測ります。
| モデル | CyScenarioBench平均solve rate |
|---|---|
| Claude Opus 5.5 | 67.6% |
| Claude Mythos 5.1 | 61.7% |
| Claude Opus 5 | 53.0% |
| Claude Sonnet 5 | 1%未満 |
この評価は10チャレンジのサブセットで実施され、サイバーセーフガードは無効化されています。Irregularは、数値は「基礎モデルの能力を引き出した条件」での性能であり、実環境での攻撃成功率を示すものではないと説明しています。
AnthropicのSystem Cardでは、ExploitBench、Binary Exploitation Benchmark、ExploitGymなどでもOpus 5.5を評価しています。ExploitGymでは、869件の対象に対して2時間の実行枠で289件、6時間で300件の成功が報告されています。Mythos 5.1はそれぞれ203件、264件でした。
これらは、一般用途のOpus系列でも、サイバー特化モデルだったMythos 5.1に近いか、一部評価では上回る基礎能力を持つことを示しています。
GPT-6 Astraとのサイバー性能は単純比較できない
OpenAIもGPT-6 Astraについて、ExploitBenchで100%、ExploitGymで42.4%を公表しています。GPT-5.6 Solはそれぞれ78.5%、30.3%でした。
ただし、この数字とAnthropicのOpus 5.5の数字をそのまま並べて「GPT-6 Astraの方が高い」「Opus 5.5の方が高い」と結論付けることはできません。
AnthropicはOpus 5.5の評価にあたりサイバー評価用ハーネスを書き換え、過去モデルも同じ条件で再評価しています。ExploitGymでもAnthropic側は869件を対象としており、OpenAIの公開評価と実行条件が完全には一致しません。ExploitBenchもベンダーごとに実行設定や評価条件が異なります。
現時点で比較しやすいのは、同一ハーネス内での相対差です。Anthropic側ではOpus 5.5がMythos 5.1とOpus 5を上回り、OpenAI側ではGPT-6 AstraがGPT-5.6 Solを上回っています。Opus 5.5とGPT-6 Astraを同一条件で直接評価した公開データがそろうまでは、クロスベンダーの順位付けは避けた方が正確です。
高いサイバー能力を持つ一方、一般ユーザーには制限がかかる
Opus 5.5のサイバー性能を見る際は、基礎モデルの能力と製品として提供される機能を分ける必要があります。
Anthropicは、Opus 5.5のサイバー能力が強いため、Fable 5.1と同等クラスのセーフガードを適用しています。通常のソフトウェア開発におけるバグの特定や修正は利用できますが、多くのサイバーセキュリティ関連タスクはOpus 4.8へ再ルートされます。
そのため、企業が「Opus 5.5のサイバー評価結果」を見て脆弱性診断、ペネトレーションテスト、マルウェア解析などへそのまま利用できると判断するのは早計です。どのタスクがOpus 5.5で処理され、どのタスクが拒否・再ルートされるかは、実際の契約形態とアクセスレベルで確認する必要があります。
AnthropicはCyber Verification ProgramをOpus 5.5へ拡大するとしています。正当な防御目的でより高度なサイバー機能を利用する組織は、この検証プログラムの対象条件も確認事項になります。
プロンプトインジェクションと自律動作の安全性も改善
Opus 5.5では、外部コンテンツに埋め込まれた悪意ある指示によってAIエージェントの行動を変えられる「間接的プロンプトインジェクション」への耐性も評価されています。
Anthropicによると、Gray Swanの評価でOpus 5.5はFable 5.1と並び、テストされたモデルの中で最も低い攻撃成功率でした。コーディング、ツール利用、コンピューター操作、WebブラウジングでもOpus 5と同等以上の耐性だったとしています。
さらにAnthropicは、モデルが与えられた境界を越えようとする傾向を測る新しい評価で、Opus 5.5の境界回避の試行がOpus 5またはMythos 5.1より約85%少なかったと報告しています。Opus 5.5が行った試行はいずれも低重大度で、モデル自身が報告したとされています。
一方、AnthropicはOpus 5.5が「評価されている」と推測している兆候もあると説明しています。評価環境で安全に振る舞った結果が、そのまま未知の実環境で再現されるとは限りません。
AIエージェントを社内システムへ接続する場合は、モデルの拒否機能だけでなく、最小権限、ネットワーク分離、ツール実行前の確認、操作ログ、外部コンテンツの取り扱いを含めて設計する必要があります。
関連:
価格はOpus 5から低下、性能だけでなく1タスク当たりのコストも改善
Claude Opus 5.5のAPI価格は、100万トークンあたり入力4ドル、出力20ドルです。Opus 5の入力5ドル、出力25ドルから20%下がりました。
キャッシュ読み取りは0.50ドルから0.20ドルへ60%低下しています。Anthropicは、エージェント型コーディングではキャッシュ読み取りがコストの大きな割合を占めるため、トークン単価だけでなく1タスク当たりの総コストでもOpus 5から約40%下がるとしています。
また、標準モードの出力速度はOpus 5より30%以上高速とされています。Claude CodeとClaude Platformでは最大2.5倍高速なFast modeも提供され、価格は入力8ドル、出力40ドル/100万トークンです。
企業で比較する場合は、単純な入力・出力単価だけでなく、1タスクあたりの出力トークン量、ツール呼び出し回数、キャッシュ利用量、再試行回数まで含めてPoCを行う方が実コストを把握しやすくなります。
情報システム部門・セキュリティ担当者が確認したいポイント
Claude Opus 5.5を企業利用する場合、性能表だけで導入可否を判断するのではなく、次の点を実環境で確認します。
- 自社の主要業務で、Opus 5.5と既存モデルの正答率、修正回数、処理時間、総トークン数を比較する
- セキュリティ業務では、拒否やOpus 4.8への再ルートが実務フローへ影響しないか確認する
- AIエージェントに付与するSaaS、Git、クラウド、端末操作権限を最小化する
- 外部Web、メール、文書、チケットなどを読ませる場合、間接的プロンプトインジェクションを前提にツール実行権限を分離する
- 生成された脆弱性指摘や修正コードを、人間のレビューとテストを通さず本番へ反映しない
- API、Claude Enterprise、クラウド経由でデータ保持条件、Zero Data Retentionの適用可否、監査ログ、SSOなどの条件を確認する
- サイバー用途で高度な機能が必要な場合は、Cyber Verification Programの対象条件と利用可能範囲を確認する
企業向け生成AIのデータ保護や管理機能を横断比較する場合は、既存のGemini・Claude・GPT・DeepSeek・Kimi K3のAIセキュリティ比較 2026で整理しています。
AI利用全体のリスク管理については、AIセキュリティとは?生成AI・AIシステムのリスクと企業のセキュリティ対策も参照してください。
出典
- Claude Opus 5.5 – Anthropic
- Claude Opus 5.5 – Claude Platform Docs
- Claude Opus 5.5 System Card – Anthropic
- Assessing Claude Opus 5.5 Against Offensive Security Benchmarks – Irregular
- GPT-6 Astra: A new generation of intelligence – OpenAI
- GPT-6 Astra System Card – OpenAI Deployment Safety Hub
関連記事
 ランサムウェア グループが日産へ不正アクセスを主張も機微な情報や個人情報漏洩は見当たらず
 藤田医科大学病院でサポート詐欺を起点に患者1,365件の個人情報漏洩のおそれ
 OCS FAMILY LINK SERVICEへのシステム障害はサイバー攻撃が原因、個人情報流出の恐れ
 教育ソフトウェア、休眠サーバーがランサムウェアの被害 自己採点システム利用者4,627件に閲覧された可能性
 ジェイコムのインターネットに大規模な障害(2026年9月23日)
 東海大学、業務委託先サーバへの不正アクセスとランサムウェアによるサイバー攻撃で個人情報漏洩の恐れ
 Google、Chromeの安定版で3件の脆弱性を緊急修正(CVE-2026-3061、CVE-2026-3062、CVE-2026-3063)
 ホテル白菊、宿泊予約・販売管理システムへの不正アクセスで個人データ流出 PC1台のマルウェア感染を確認
 中国で富士電機 社員 2名 拘束→逮捕か-密輸罪の拡大解釈と2026年7月施行 民族団結進歩促進法が生む新リスク