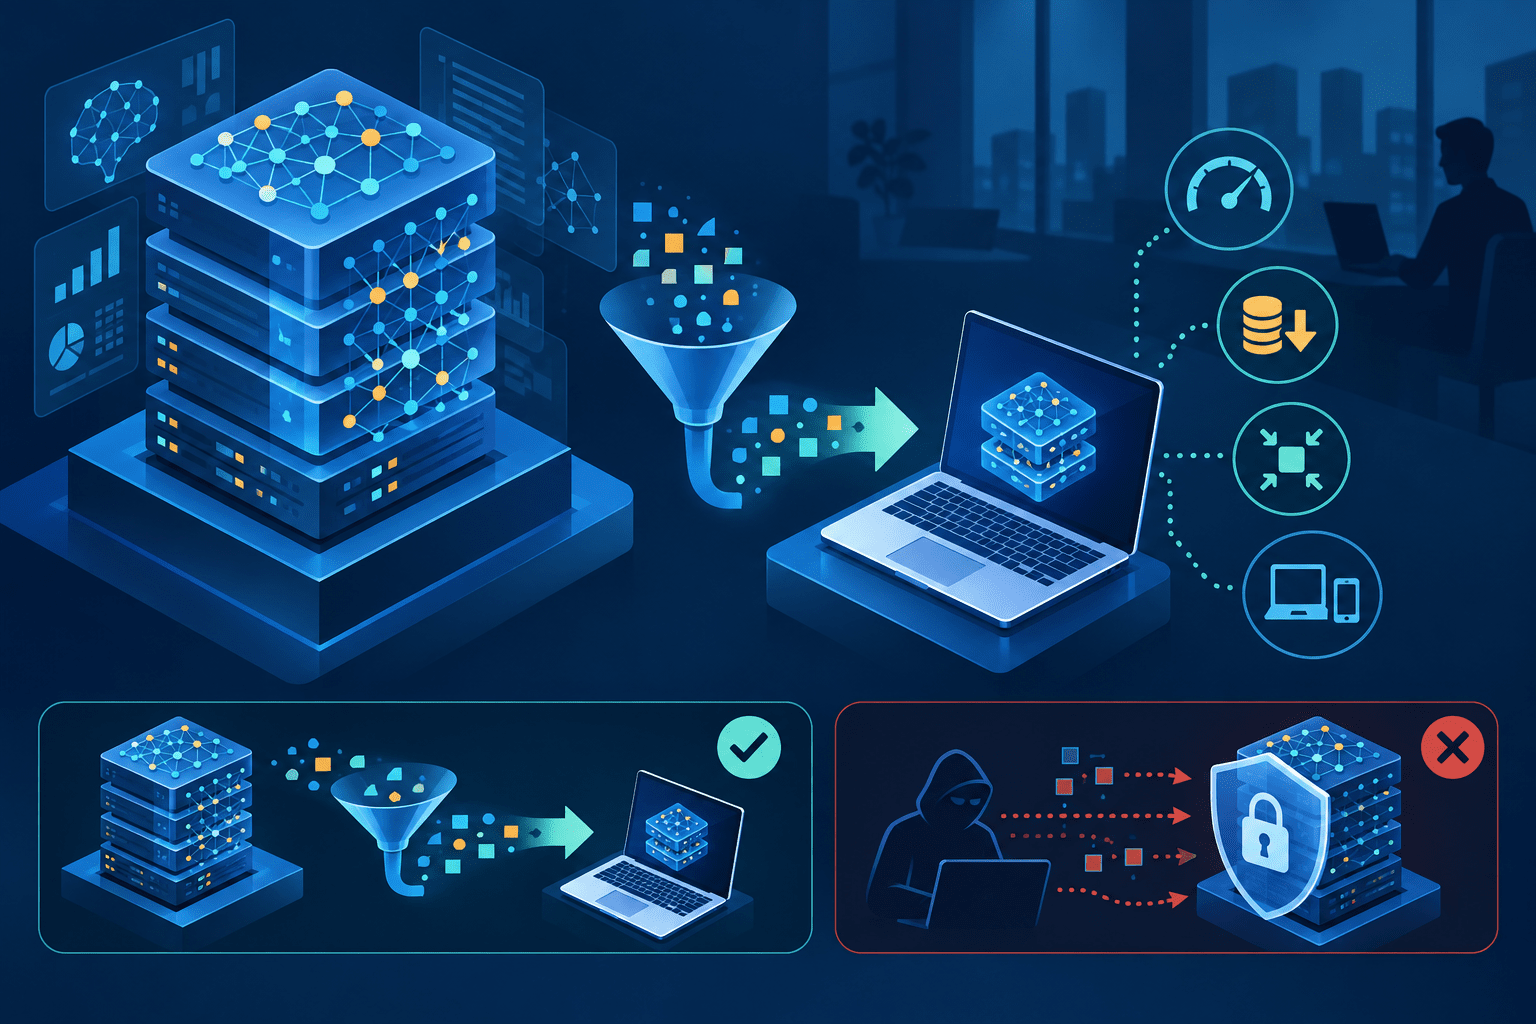
AIの「蒸留(Model Distillation/Knowledge Distillation)」とは、高性能な大規模モデルの振る舞いや知識を、より小さく軽量なモデルへ移す学習手法です。
一般には、大きな「教師モデル(Teacher Model)」の出力を、小さな「生徒モデル(Student Model)」の学習に利用します。目的は、教師モデルに近い性能を維持しながら、推論コスト、必要なGPU・CPU、応答時間、運用コストを減らすことです。
蒸留そのものは攻撃手法ではありません。英国政府は2026年8月に公開した「AI Insights: Model Distillation」で、蒸留をモデル圧縮の一般的な手法として整理しています。米国NSA、CISA、FBIも2026年9月の共同勧告で、蒸留自体はAI研究で認められた有用な技術だとしたうえで、他社モデルから許可なく能力を抽出する「産業規模の蒸留」を別の問題として扱っています。
企業が理解しておきたいのは、「自社モデルを軽量化する正当な蒸留」と「外部AIへ大量の問い合わせを行い、その出力から競合モデルの能力を再現するモデル抽出」を分けることです。
AIの蒸留とは
モデル蒸留では、性能の高い教師モデルから得た情報を使い、生徒モデルを学習させます。
基本的な流れは次のとおりです。
- 教師モデルへ学習用の入力を与える
- 教師モデルから回答や予測結果を取得する
- その結果を生徒モデルの学習データとして利用する
- 生徒モデルが教師モデルに近い振る舞いをするよう調整する
- 評価データで教師モデルとの性能差を確認する
通常の教師あり学習では、人間が付与した正解ラベルを学習します。
一方、蒸留では教師モデル自身の出力が「教師」の役割を持ちます。単純な正解だけでなく、出力確率、中間表現、推論過程などを使う場合もあります。
英国政府は、蒸留を「大規模で高精度なモデルの予測行動を、より小さく計算効率の高いモデルへ移す手法」と説明しています。
なぜAIを蒸留するのか
蒸留の主な目的は、AIモデルの性能を一定程度維持しながら、実運用しやすいサイズとコストへ縮小することです。
英国政府の「AI Insights: Model Distillation」では、主な利点としてコスト削減、プライバシー・セキュリティ、外部ベンダーへの依存低減、柔軟な導入を挙げています。
推論コストを下げる
フロンティアモデルは数百億~数千億規模のパラメータを持つ場合があり、推論にも高性能GPUや大きなメモリが必要です。
蒸留後のモデルを小型化できれば、同じ処理量でも必要な計算資源を減らせます。
英国政府資料では、蒸留モデルが特定タスクにおいて教師モデルの性能の80~95%程度を維持しながら、計算資源を大幅に削減できるケースを紹介しています。
この数値はすべてのモデルや用途で保証されるものではなく、蒸留対象のタスクや教師モデル、生徒モデル、学習データによって変わります。
応答を高速化する
小型モデルは必要な計算量が少ないため、リアルタイム処理に向きます。
たとえば、
- チャットサポート
- コンテンツフィルタリング
- エッジ端末
- モバイル端末
- リアルタイム判定
などでは、最高性能のモデルを毎回呼び出すより、小型化した専用モデルの方が運用しやすい場合があります。
特定業務へ能力を集約する
教師モデルが持つ幅広い能力すべてを小型モデルへ移す必要はありません。
法務文書分析、問い合わせ分類、コンテンツ検査など、必要な領域へ絞って蒸留することで、小型モデルでも業務に必要な性能を確保しやすくなります。
オンプレミスや閉域環境で利用する
英国政府は、蒸留後の小型モデルをオンプレミスで運用することで、機密データを管理下のインフラ内に保持できる利点も挙げています。
外部AI APIへ機密情報を送れない組織では、性能とデータ管理のバランスを取る手段になります。
外部AIサービスへの依存を減らす
外部APIだけに依存したシステムでは、
- API料金の変更
- 障害
- モデル提供終了
- 利用条件の変更
- 地域制限
が業務へ影響します。
蒸留したモデルを自社環境で運用すれば、一部の処理を外部サービスから切り離せます。
AI蒸留の主な4つの手法
英国政府はモデル蒸留の代表的な方法として4種類を整理しています。
| 手法 | 何を教師から学ぶか | 主な特徴 |
|---|---|---|
| Response-based distillation | 最終出力、確率分布 | 教師の回答傾向を生徒が再現する |
| Feature-based distillation | 中間層・内部表現 | 教師内部の特徴表現まで近づける |
| Self-distillation | 同一モデルの後期Checkpoint等 | 別の教師モデルを用意せず学習する |
| Chain-of-Thought distillation | 推論過程・説明 | 複数段階の推論や問題解決能力を移す |
Response-based distillation
最も理解しやすいのが、教師モデルの出力を生徒モデルへ学習させる方法です。
分類モデルでは、教師モデルが出力する単純な正解ラベルだけではなく、各候補に対する確率分布を学習させることがあります。
LLMでは、教師モデルが生成した回答を学習用データとして利用する方法がこれに近い考え方です。
外部APIしか利用できない場合でも出力は取得できるため、他社モデルの能力を再現するモデル抽出にも使われやすい方式です。
Feature-based distillation
教師モデルの最終回答だけではなく、中間層の活性値や内部表現を生徒モデルへ学習させます。
この方法は教師モデル内部へアクセスできることが前提になる場合が多く、自社モデルや利用権限を持つモデルの圧縮に向いています。
外部の商用APIでは通常、内部のhidden stateや重みへアクセスできないため、ブラックボックス型のモデル抽出とは条件が異なります。
Self-distillation
別の大型教師モデルを用意せず、同一モデルの学習途中のCheckpointや異なる層を教師として利用する方法です。
外部モデルを使わないため、モデル改善のための内部的な学習方法として利用できます。
Chain-of-Thought distillation
教師モデルの最終回答だけでなく、問題を解くまでの推論過程を生徒モデルへ学習させる方法です。
英国政府は、数学、論理推論、複数ステップの問題解決などで利用される手法として整理しています。
近年、フロンティアモデルの競争では、単なる知識量だけでなく「どのように問題を分解して解くか」という推論能力そのものが価値を持つようになっています。
そのため、他社モデルから推論能力を抽出する目的でもChain-of-Thoughtが焦点になっています。
蒸留とファインチューニング、量子化、モデル抽出の違い
AIモデルを小型化・改善する技術は蒸留だけではありません。
| 手法 | 主な目的 | 教師モデル | モデルの重みを変更 | 外部モデルからの能力抽出 |
|---|---|---|---|---|
| 蒸留 | 教師の能力を小型モデルへ移す | 必要 | 生徒側を更新 | 方法によって可能 |
| ファインチューニング | 特定用途へモデルを追加学習 | 必須ではない | 更新する | 通常は目的ではない |
| 量子化 | 重みの数値精度を下げ軽量化 | 不要 | 表現形式を変更 | しない |
| モデル抽出 | 対象モデルの機能を再現する | 対象モデルを利用 | 複製モデルを学習 | 主目的 |
この中で混同されやすいのが「蒸留」と「モデル抽出」です。
蒸留は学習手法です。
モデル抽出は、対象モデルの挙動や能力を再現するという攻撃者側の目的・行為を指します。
英国NCSCはModel Extraction Attackについて、対象モデルへ繰り返し問い合わせ、その出力を利用して代替モデルを構築する攻撃と説明しています。
つまり、モデル抽出を行うための技術として蒸留が利用される場合があります。
「蒸留=モデル窃取」ではありません。
外部AIを利用した蒸留はどのように行われるのか
自社が教師モデルの重みや内部表現を持っていない場合でも、APIやWebサービスから返される回答を学習データとして利用することは技術的に可能です。
高レベルでは、次のような流れになります。
- 対象モデルへ多数の質問を送る
- 回答を収集する
- 入力と回答のペアから学習データを作る
- 生徒モデルを学習する
- 対象能力が再現できているか評価する
- 足りない領域について追加データを取得する
NCSCはモデル窃取について、対象への問い合わせからデータを収集し、モデルのアーキテクチャや学習特性を推測しながら代替モデルを構築する行為と説明しています。
モデルそのものの重みを盗まなくても、十分な入出力データが得られれば「振る舞い」を近づけられる点が特徴です。
なぜ競合AIから蒸留するのか
フロンティアモデルをゼロから開発するには、
- 大量のGPU
- 電力
- 学習データ
- 研究者
- 学習時間
- 評価環境
が必要です。
すでに高性能なモデルが存在する場合、そのモデルが生成した高品質な回答を学習データに使えば、自社だけで同等のデータを作る場合より開発時間やコストを圧縮できる可能性があります。
米NSAは2026年9月の勧告で、競合するフロンティアモデルから能力を抽出することで、研究開発、計算資源、電力、基礎研究に必要なコストを抑えながら技術差を縮められると評価しています。
これは正当な自社モデルの蒸留とは異なり、第三者モデルの利用規約やアクセス制限を回避して能力を取得するケースを対象とした説明です。
「蒸留攻撃」と呼ばれるのはどのような場合か
通常の蒸留とセキュリティ上問題となる蒸留は分けて考える必要があります。
正当な蒸留の例
- 自社の大型モデルを小型化する
- ライセンス上認められたモデルを教師として使う
- 公開モデルをライセンス条件に従って蒸留する
- 自社データと自社モデルで専用モデルを作る
問題になり得る蒸留の例
- 利用規約で学習利用を禁止された出力を大量取得する
- 地域制限やアクセス制御を回避する
- 多数のアカウントを使ってレート制限を回避する
- 第三者の非公開モデルから独自機能を再現する
- 取得元を隠しながら大量の出力を収集する
どの行為が法的に違法となるかは、契約、知的財産法、取得方法、管轄地域などによって異なります。
「蒸留」という技術自体に違法性があるわけではありません。
中国AIの「産業規模の蒸留」が問題になっている理由
2026年9月8日、米NSA、CISA、FBIは、中国に拠点を置くAI企業6社が米国製フロンティアモデルに対して「industrial-scale distillation」を行ったとする共同サイバーセキュリティ勧告を公表しました。
米側が名指ししたのは、
- DeepSeek
- Moonshot AI
- Alibaba
- MiniMax
- StepFun
- Z.AI
です。
米政府は、これら企業がClaude、GPT、Gemini、Grokなどへ多数のリクエストを送り、数十億トークン規模のデータや能力を自社モデルの学習へ利用したと評価しています。
一方、中国政府は米側の主張を否定し、蒸留はAI業界で一般的に利用される中立的な技術だと反論しています。
ここで争点になっているのは、蒸留という技術そのものではありません。
米側は、地域制限、利用規約、アカウント制限などを回避しながら競合モデルの非公開能力を組織的に抽出したと評価しています。
中国AI企業を巡る具体的な対象モデル、規模、アクセス経路、米中双方の主張については、以下の記事で整理しています。
関連:米政府、中国AI企業6社の「産業規模の蒸留」を名指し DeepSeek・Moonshot・Alibabaなど
蒸留モデルにも教師モデルの問題が引き継がれる
蒸留は性能だけを移すわけではありません。
教師モデルの出力を大量に学習させるため、
- 誤答
- バイアス
- 特定の表現傾向
- 安全制御の弱点
- 不適切な応答パターン
が生徒モデルへ引き継がれる可能性があります。
英国政府も、蒸留モデルは教師から学習した範囲に性能が制約され、対象領域が変わると性能が低下する可能性を説明しています。
また、広い領域を表面的に模倣しただけでは、回答は自然でも専門的な精度が不足する「shallow imitation」が発生する可能性があります。
蒸留後は「教師モデルに似ているから安全」と判断せず、生徒モデル単体で評価する必要があります。
企業がAI蒸留で確認したいポイント
AIを開発・調達する企業では、蒸留の有無だけでなく「何を教師にし、どのデータを使い、どの権利で学習したか」を確認します。
自社で蒸留する場合
- 教師モデルの利用規約で学習利用が許可されているか
- 学習データに機密情報や個人情報が含まれていないか
- 教師モデルの出力をどこまで保存するか
- 生徒モデルに教師の安全上の問題が引き継がれていないか
- 蒸留後のモデルを独立して安全性評価しているか
外部モデルを調達する場合
- 基盤モデルと教師モデルの出所
- 蒸留に使用したモデル・データの説明
- 学習データの権利関係
- モデルカードやAIBOM
- ベンダーによるデータ provenance の説明
- ライセンスと二次利用条件
イスラエル国家サイバー局(INCD)は蒸留そのものを個別に定義しているわけではありませんが、AI機能を利用する組織に対し、AIライフサイクル全体へセキュリティ対策を適用し、利用するAIコンポーネントのAIBOMを最新状態で保持するよう案内しています。
蒸留モデルを導入する場合も、単にモデル名だけを資産台帳へ登録するのではなく、基盤モデル、学習元、依存ライブラリ、提供者、バージョンなどを追跡できる状態にすると、脆弱性や供給網リスクの確認がしやすくなります。
AIサービス提供者はモデル抽出を前提に監視する
NCSCは、公開されたAIモデルへの詳細な出力が攻撃者によるモデル抽出を容易にする場合があると説明しています。
AI APIを提供する側では、
- 大量の反復クエリ
- 複数アカウント間で類似する問い合わせ
- 通常利用と異なる高頻度アクセス
- 特定能力だけを網羅的に取得する問い合わせ
- API、クラウド、リセラーをまたぐ利用
などを監視対象にできます。
ただし、大量利用だけで蒸留と断定すると、正規のバッチ処理やAIエージェントを誤検知します。
米NSA、CISA、FBIの2026年勧告も、単一指標ではなく複数のプロバイダー、クラウド、APIアグリゲーターをまたいだ情報共有と検知を推奨しています。
情報システム部門が確認したいこと
企業側でAI蒸留を確認する場合は、まず「蒸留を禁止するか」ではなく、利用目的と権利関係を整理します。
自社モデルの小型化であれば、コスト削減、閉域運用、レイテンシ低減に有効な選択肢です。
一方、外部AIの出力を学習へ再利用する場合は、
- 契約上の利用条件
- 学習データの取得方法
- モデルの出所
- API利用の正当性
- 知的財産
- セキュリティ評価
を確認します。
外部の蒸留済みモデルを調達する場合は、「性能が高い」「安い」だけでなく、どの教師モデル・データから作られたのかを調達時の確認項目に含める必要があります。
蒸留はAIを軽量化する一般技術であると同時に、他社AIの能力を低コストで再現する手段にもなります。
企業にとっての判断軸は「蒸留かどうか」ではなく、「誰のモデルを、どの権限で、どのデータと手順を使って蒸留したか」です。
出典
米国
- Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations(NIST AI 100-2 E2025) – NIST
- NSA and Others Warn China-Based AI Companies are Distilling U.S. Frontier AI Models – National Security Agency
英国
- AI Insights: Model Distillation – GOV.UK
- Machine learning principles – Secure deployment – National Cyber Security Centre
- Protect information that could be used to attack your model – National Cyber Security Centre
- Understanding adversarial attacks against Machine Learning and AI – National Cyber Security Centre
イスラエル
- Securing artificial intelligence (AI) capabilities – Israel National Cyber Directorate
- Israel International Cyber Strategy – Israel National Cyber Director
関連記事
 EDRとは?意味やウイルスソフトやUTMとの違いを解説
 MDRとEDRの違いとそれぞれの特徴を解説 必要性や導入のアドバイスまで
 EDRとSOCの違いと関係性を徹底解説 自社に最適なセキュリティソリューションを
 EPPとEDRの違いとは 両者の比較と組み合わせの効果についても解説
 XDRはEDRの進化版? それぞれの基本的な知識から違いまで解説
 EDRとアンチウイルスの違いとは マルウェア対策に欠かせない二つのソリューション
 EDRについてわかりやすく解説 機能や構造から運用まで
 EDR 運用のありがちな課題と効果的な運用方法を解説
 EDRを効果的に導入しよう メリット・デメリットと事例も踏まえて解説

