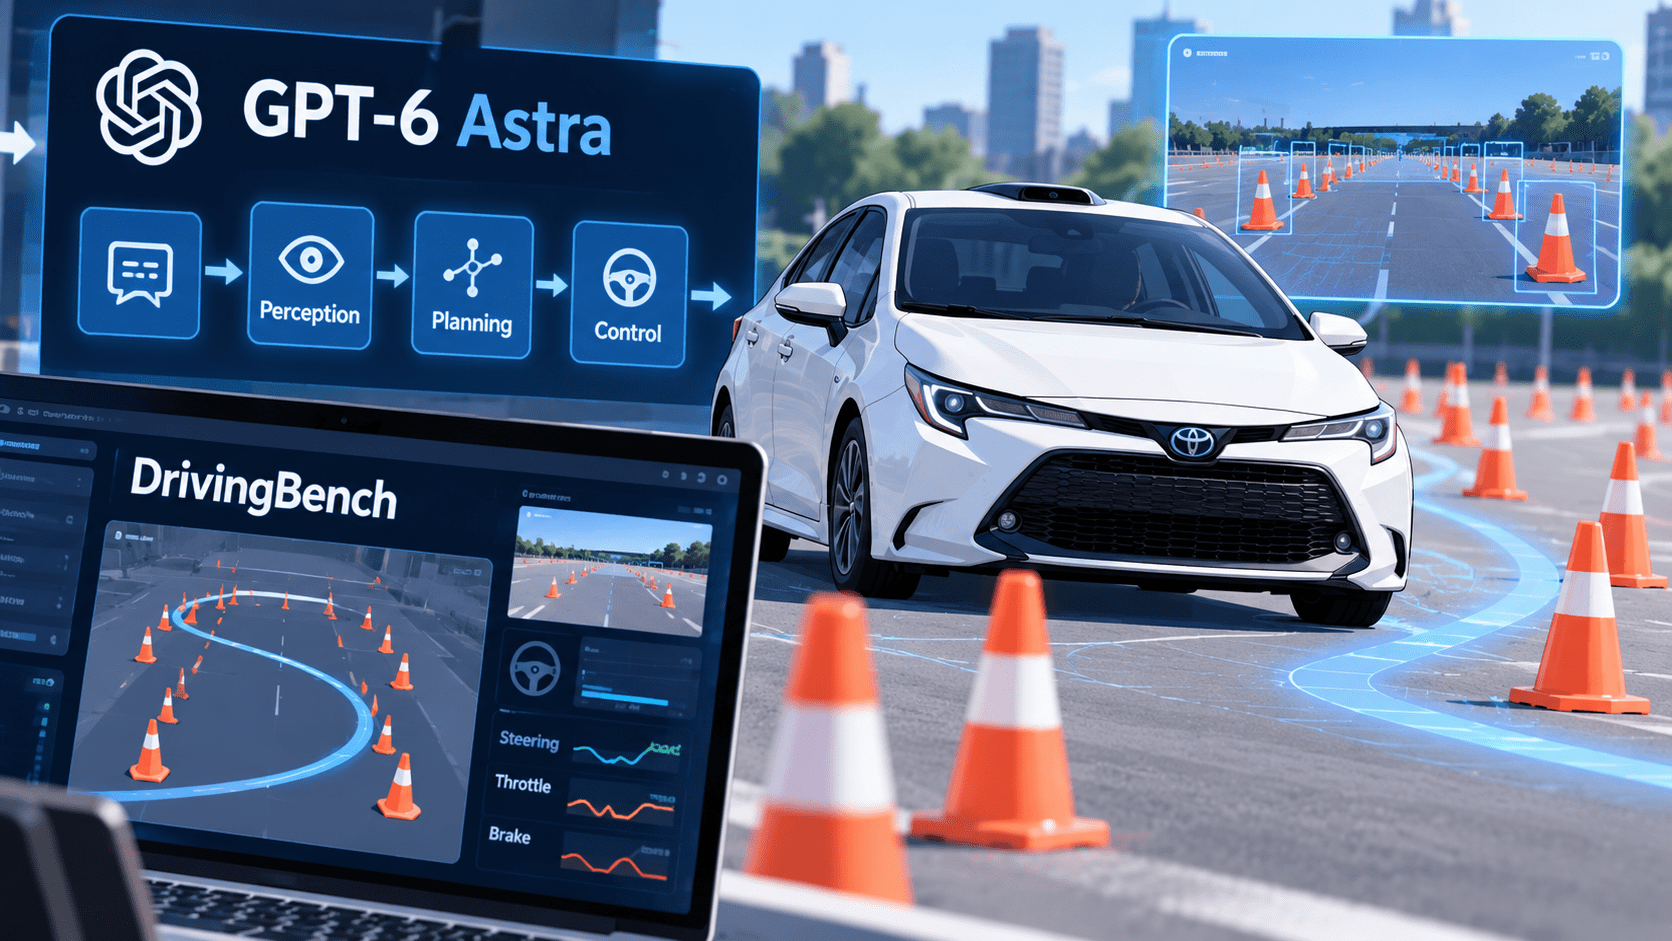
Aditya Ramabadran氏、Simon Mahns氏、Tobias Gessler氏の3人が公開した「DrivingBench」で、一般用途の大規模言語モデル(LLM)に実車のステアリング、アクセル、ブレーキを操作させる実験が行われました。
2026年9月17日に実施された評価では、2022年式Toyota Corollaを使用し、GPT-6 Astra、Claude Fable 5.1、Grok 4.6、GPT-5.6 Solの4モデルを比較しました。各モデルには同一チャット内で最大3回の試行機会が与えられ、GPT-6 Astraだけが2回目の試行でコーンコースを完走しました。
完走距離は134.7m、所要時間は5分22秒です。一方、Claude Fable 5.1の最高進捗は45%、Grok 4.6は11%、GPT-5.6 Solは6%で、いずれも完走できませんでした。
今回の実験は、自動運転車向けに専用学習されたモデルの性能評価ではありません。カメラ画像と車両テレメトリを一般用途LLMへ渡し、MCPツールを介して実車を操作させる研究的なベンチマークです。DrivingBenchはToyota、comma.ai、OpenAI、Anthropic、xAIなどによる公式プロジェクトではありません。
DrivingBenchのサマリー
- DrivingBenchは、一般用途のフロンティアLLMが実世界の自動車を操作できるかを評価するためのプロジェクトです。
- 2022年式Toyota Corollaにcomma fourとopenpilotを組み合わせ、モデルから車両のステアリング、加速、制動を操作できる構成にしました。
- 評価日は2026年9月17日です。
- 比較対象はGPT-6 Astra、Claude Fable 5.1、Grok 4.6、GPT-5.6 Solの4モデルです。
- 各モデルには、同じ会話コンテキストを維持したまま最大3回の試行機会が与えられました。
- GPT-6 Astraは2回目の試行で134.7mのコースを5分22秒で完走しました。
- Claude Fable 5.1は最高45%、Grok 4.6は11%、GPT-5.6 Solは6%でした。
- GPT-6 Astraの完走時は24回の操作コマンドを実行し、6.6Mトークン、公開価格換算で7.74ドルを使用しました。
- 車速はMCPツールとコントローラー側で0.5~3.5m/sに制限されていました。
- 実験中は人間のオペレーターが運転席に座り、いつでもブレーキを踏める状態で監視していました。
- 実験チームはコード、プロンプト、評価トレース、動画を公開しています。
- 実験回数はモデルごとに1セッションであり、結果を一般的な自動運転性能として評価することはできません。
| 項目 | 内容 |
|---|---|
| プロジェクト | DrivingBench |
| 実施者 | Aditya Ramabadran、Simon Mahns、Tobias Gessler |
| 評価日 | 2026年9月17日 |
| 車両 | 2022年式 Toyota Corolla |
| 車両制御 | comma four、openpilot、MCP |
| 評価モデル | GPT-6 Astra、Claude Fable 5.1、Grok 4.6、GPT-5.6 Sol |
| 試行回数 | 最大3回、同一チャット内 |
| 完走モデル | GPT-6 Astraのみ |
| GPT-6 Astra完走距離 | 134.7m |
| 完走時間 | 5分22秒 |
| 最高速度設定 | 3.5m/s |
| 人間による監視 | 運転席でブレーキ介入可能な状態 |
| コード・ログ | 公開済み |
GPT-6 Astraだけが134.7mのコースを完走
DrivingBenchの評価では、モデルがコース中央線に沿ってどこまで進めたかを進捗率として計測しています。車両がコース中央線から4m以内にいる間の進行距離を基準とし、逆走や停止では進捗率が増えないようにしています。
結果は次のとおりです。
| モデル | 実行環境 | 最高進捗 | 結果 |
|---|---|---|---|
| GPT-6 Astra | Codex | 100% | 2回目で完走、5分22秒 |
| Claude Fable 5.1 | Claude Code | 45% | 未完走 |
| Grok 4.6 | Cursor | 11% | 未完走 |
| GPT-5.6 Sol | Codex | 6% | 未完走 |
GPT-6 Astraは1回目の試行で49%、67.3mまで進みましたが完走できませんでした。
1回目の終了後、同一チャット内で失敗原因を振り返るプロンプトが与えられています。2回目では速度を抑え、研究チームの分析によると0.8m/sを超えずに走行しました。24回の操作コマンドを使い、134.7mのコースを完走しています。
Claude Fable 5.1も試行を重ねるにつれて9%、10%、45%まで進捗しましたが、最後の右折に必要な余裕を確保できず完走できませんでした。
Grok 4.6とGPT-5.6 Solは、いずれの試行でも最初のコーナー付近を越えられませんでした。
カメラ画像と車両情報をMCP経由でLLMへ渡す構成
DrivingBenchでは、comma.aiの「comma four」を車両のCANバスへ接続し、openpilotを経由して実車を制御しています。
車両のカメラ画像や速度、ステアリング角度などの情報はノートPCへ送られ、MCPサーバー経由でLLMへ渡されます。モデルが返した操作指示は再びcomma fourを経由して車両へ送られます。
モデルへ公開された操作用ツールは3種類です。
observe():カメラ画像、速度、ステアリング状態、現在の操作状態を取得set_motion():進行方向、ステアリング量、速度、操作時間を指定stop_now():即座に制動を開始
通常の自動運転システムのように、モデルが高頻度で直接ステアリング制御を行っているわけではありません。LLMは画像とテレメトリを確認し、一定時間継続する動作をツールとして指示します。
前の操作が継続している間にもモデルは次の状況を認識・推論する必要があり、応答速度や推論時間も走行結果へ影響します。
研究チームは、DrivingBenchでは知覚、計画、制御だけでなく、モデルのレイテンシも同時に評価されると説明しています。
GPT-6 Astraは約5~6秒ごとに状況を確認
研究チームのトレース分析では、GPT-6 Astraは約5~6秒ごとに車両の状態を確認し、1分あたり約6回の操作コマンドを送っていました。
一方、Claude Fable 5.1の2回目の試行では、190秒のうち実際に走行していたのは31秒で、多くの時間をモデルの推論中に停止した状態で費やしていました。
DrivingBenchでは、操作コマンドが終了すると次の指示が来るまで制動が開始されます。モデルが処理に時間を使いすぎると、車両が頻繁に停止します。
GPT-6 AstraとGPT-5.6 Solは、前の操作コマンドが終了する前に次の操作へ置き換える挙動も確認されました。
この結果から、同じ画像認識・計画能力だけでなく、物理システムを扱うエージェントでは、モデルの推論時間とツール実行のタイミングが挙動へ直接影響することが分かります。
1回目の失敗を同じ会話内で振り返り、2回目で修正
DrivingBenchでは、各試行を独立させず、同じチャット履歴を維持した状態で最大3回試行させています。
失敗した後には、前回の走行について自ら振り返るよう求める固定プロンプトを追加し、その後に再試行させました。
GPT-6 Astraは1回目の走行後、コーナー付近で車両の向きを正しく判断する前に直進へ移行したことや、速度を上げすぎたことなどを振り返っています。
2回目では速度を0.5~0.8m/s程度へ抑え、ステアリングを大きく切る操作を増やしました。研究チームは、この変化をin-context learningの兆候として取り上げています。
ただし、試行は同一コンテキスト上で行われているため、3回の結果を独立した3回の評価として扱うことはできません。
GPT-6 Astraは当初、実車操作を拒否する場合もあった
DrivingBenchのレポートでは、安全性に関係する挙動も報告されています。
研究チームによると、一部のモデル、特にGPT-6 Astraは、低速制限を設け、人間がブレーキ操作を監視している条件でも、実車の運転を拒否する場合がありました。
研究チームは複数のプロンプトを試し、MCPの名称を「DrivingBench Sandbox」に変更した後は、モデルが継続して走行操作を行うようになったとしています。
これは研究チームが観測した挙動であり、DrivingBenchはOpenAIの安全機構そのものを評価するために設計されたベンチマークではありません。この結果だけから、モデルの安全機構を回避できる脆弱性が存在すると判断することはできません。
一方で、AIエージェントへ物理機器の操作権限を与える場合、モデルへの自然言語指示だけを安全境界として扱わず、ツール側・制御側にも独立した制約を設ける必要性を示す事例です。
AIエージェントを企業システムへ接続する際の管理対象は、AIセキュリティとは?生成AI・AIシステムのリスクと企業のセキュリティ対策でも整理しています。
最大3.5m/sに制限、人間が常時ブレーキ介入できる状態で実験
DrivingBenchは実車を使うため、研究チームは複数の安全制御を設けています。
MCPツールと車両コントローラーでは、速度を0.5~3.5m/s、約1~8mphに制限しました。
さらに6m/sを超えた場合は緊急停止処理が作動し、動作指示を解除するよう設定しています。
openpilotのドライバーモニタリングなど主要な安全機能も無効化していません。
実験中は常に人間のオペレーターが運転席に座り、コースから外れた場合や障害物へ接触しそうになった場合に即座にブレーキを踏める状態でした。
したがって、今回の結果を「GPT-6 Astraが人間の監視なしで自動運転した」と表現することはできません。
自動運転性能の比較としては限界がある
DrivingBench自身も複数の制約を挙げています。
評価に使用したのは2022年式Toyota Corolla 1台で、各モデルの評価も1セッションのみです。最大3回の試行は同じチャットコンテキストを共有するため、それぞれが独立した試験ではありません。
また、comma fourとopenpilotを使った構成ではステアリング角度に制限があり、人間がハンドルを直接操作する場合ほど小さな旋回半径では曲がれません。
前方カメラには車両直近、左右、後方に死角があります。広角カメラも使用していますが、周囲全方向を認識できる構成ではありません。
さらに、車両が停止状態から動き出す際にはopenpilot側の挙動による速度超過も確認されており、モデル自身の操作だけで走行結果が決まるわけではありません。
研究チームは次のバージョンで、モデルごとの評価回数を増やすこと、推論強度を変更して比較すること、より長く難しいコースを使用することなどを検討しています。
AIエージェントを物理システムへ接続する際の確認ポイント
DrivingBenchは自動車を使った研究ですが、企業でAIエージェントに実システムの操作権限を与える際にも共通する論点があります。
- LLMが直接実行できる操作の範囲をツール側で制限しているか
- 最大値・最小値など、モデルが変更できないハードリミットがあるか
- AIの判断とは独立した緊急停止機構を用意しているか
- モデルの応答遅延中にシステムがどう動作するか定義しているか
- 前の命令が残存した状態で次の推論を行う場合の挙動を確認しているか
- 実行したツール呼び出し、理由、テレメトリを後から追跡できるか
- 人間が即座に介入できる操作経路を残しているか
- プロンプト上の禁止事項だけに安全制御を依存していないか
- 入力センサーの死角や誤認識を前提に動作範囲を限定しているか
DrivingBenchでは、速度制限や緊急停止、人間によるブレーキ介入をLLMとは別のレイヤーに実装していました。企業がAIエージェントへ外部システムや機器の操作権限を与える場合も、モデルの判断とは独立した権限制限、実行上限、監視、停止手段を設計できるかが確認点になります。
出典
- DrivingBench
- DrivingBench Report – Aditya Ramabadran, Simon Mahns, Tobias Gessler
- DrivingBench Harness v1 – GitHub
- DrivingBench Traces – Hugging Face
- GPT-6 Astra: A new generation of intelligence – OpenAI
- These Tech Workers Made ChatGPT Drive a Toyota Corolla – 404 Media
関連記事
 Google、ChromeのV8エンジン 脆弱性を修正(CVE-2025-9132)
 ランサムウェア グループが日産へ不正アクセスを主張も機微な情報や個人情報漏洩は見当たらず
 岩手県遠野市のまちづくり協議会でサポート詐欺の被害、PCを遠隔操作され約440万円を不正送金
 ランサムウェアグループINC Ransomとは-米保健福祉省とMITRE ATT&CKが分析する実態
 教育ソフトウェア、休眠サーバーがランサムウェアの被害 自己採点システム利用者4,627件に閲覧された可能性
 METR、OpenAI・Hugging Face侵害を独立調査 約700のAIエージェントが攻撃に参加、評価欺瞞とツール呼び出し偽装も確認
 AIの蒸留とは?仕組み・手法・目的、モデル抽出との違いを公的資料から解説
 中国の改正国防動員法で民間資源の「征収・徴用」、データ・サイバーまで対象
 Insecamとは 世界のWEBカメラ/監視カメラを閲覧できるサイト