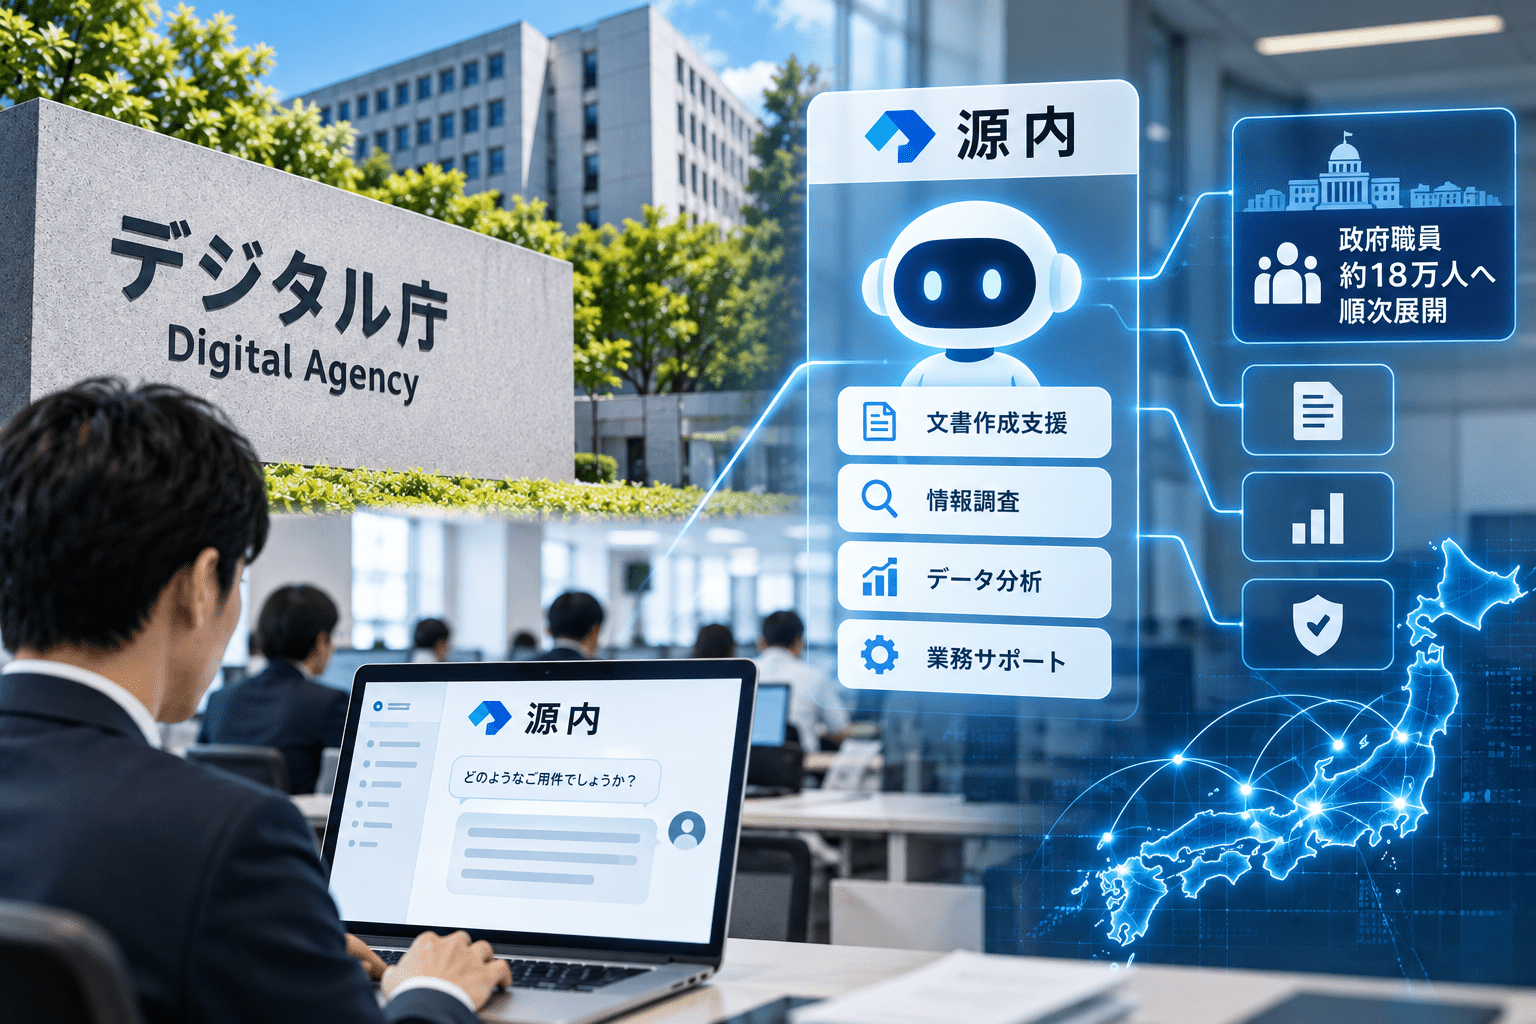
デジタル庁は2026年10月20日、政府共通の生成AI利用環境「源内(げんない)」にAIエージェント機能を追加し、各府省庁等へ順次導入すると発表しました。職員が業務に合わせてAIエージェントを作成・実行できる「エージェントチャット」の提供を始め、より高度な「源内工房」は12月頃の導入を目指します。あわせて、利用者・管理者・開発者の責務や、機密情報の取り扱い、外部通信、基盤モデルの選定などを定めた「源内基準」を公表しました。
今回の発表は、行政文書の要約や質問応答に使う生成AIを、ファイル操作やプログラムの実行を伴う業務処理へ拡張する取り組みです。政府がAIを大規模に活用する場合、性能や利便性だけでなく、海外事業者への依存、行政データの管理権限、国際情勢の変化によるサービス遮断、国内のAI技術基盤の維持まで含めた設計が必要になります。
約18万人は2026年度中に源内を利用可能とする政府の展開計画における対象規模であり、10月20日時点ですべての職員が新機能を利用しているわけではありません。今回公表された「源内基準」は、こうした背景を踏まえ、「自律性・代替性・耐遮断性」を確保するAI主権(AIソブリンティ)を基本方針に位置付けています。
「源内」AIエージェント導入のサマリー
- 公表日:2026年10月20日。デジタル庁がAIエージェント利用環境と「源内基準」を公表。
- 「エージェントチャット」は10月20日から各府省庁等へ順次導入。
- 「源内工房」は2026年12月頃の導入を目指す、高度な調査・開発向け環境。
- 約18万人は2026年度中に源内を利用可能とする計画上の対象規模。
- 「源内基準」はAISIの協力を得て策定。利用者・管理者・開発者の責務を区分。
- 国産AIに限定せず、国内外のモデルを安全性・性能・業務適合性・費用等で評価する方針。
- 原則として国内のガバメントクラウドで推論とデータ保存を行い、特定条件下で海外推論を例外的に認める。
- AI主権を「自律性・代替性・耐遮断性」として整理し、モデルやクラウドを切り替えられる構成を目指す。
- 「源内OSS Ver.2.0」は2027年2月頃の公開予定。自治体・民間による利用も想定。
| 項目 | エージェントチャット | 源内工房 |
|---|---|---|
| 主な用途 | 資料作成、ファイル処理、集計など日常業務の複数工程を実行 | 高度な調査、プログラム作成・実行、Webアプリ等の試作 |
| 利用画面・環境 | 源内のチャット画面 | 個人向け専用開発環境 |
| 導入予定 | 10月20日から順次 | 12月頃を目指す |
| 利用・操作の制限 | 利用者本人のマイドライブ内に作業対象を限定。アップロードした原本は上書き・改変しない | 利用申請・権限付与を前提とし、外部へのPOST・PUT通信を制限、操作記録を取得 |
「源内」に追加される機能――チャットから業務を実行するAIへ
源内はこれまで、チャット、翻訳、文書作成、法令調査、国会答弁作成支援、公用文校正など、政府職員の日常業務を支援するAIアプリケーションを提供してきました。2026年5月からは全府省庁を対象とする大規模実証を進めています。
新たなエージェントチャットは、利用者の指示に沿って、CSVの集計、資料生成、ファイル操作、コード実行など、複数の処理を連続して進めるものです。源内工房は、Web上の情報収集や比較、プログラムの作成・修正・実行、動作確認を伴うプロトタイプ開発などを想定します。
デジタル庁は、職員が作成した業務手順やAIエージェント用の「スキル」を共有・再利用する「源内ライブラリ」の整備も進めています。ただし、共有される処理手順の審査、評価、版管理などは引き続き整備すべき課題です。共有元が行政機関であるというだけで、誤処理や不正な指示の混入がなくなるわけではありません。
政府全体で同様の文書整理や集計を個々の部署が繰り返し実装するのではなく、安全性と品質を確認した手順を再利用できれば、業務の効率化や職員のスキル形成につながります。一方、エージェントが触れられるデータや処理の範囲は、従来のチャットより厳格に管理する必要があります。
なぜ今、ソブリンAIが国家の課題になっているのか
AIは便利な外部サービスから、行政・産業を支える基盤技術へ変わりつつある
日本政府は2026年7月14日、人工知能基本計画(第Ⅱ期)を閣議決定しました。同計画は、エージェント型AIの進展を背景に、AIの社会実装能力が経済力、防衛力、技術力などの国力に関わると整理しています。さらに、計算資源や電力、データ、人材、システムを制御する能力も含めたAI基盤の整備を掲げました。
これまで生成AIは、職員や従業員が必要なときに文書の要約や翻訳を依頼する道具として位置付けられる場面が多くありました。しかし、調査、資料作成、システム操作、プログラム実行といった業務工程に組み込まれるほど、AIを利用できない状態が行政の作業能力やサービス提供へ影響する場面も増えると考えられます。
例えば、特定の海外AIモデルへの接続が突然できなくなった場合、単にチャットが使えなくなるだけで済むとは限りません。業務手順の一部をAIエージェントに組み込んでいた部署では、別モデルへの切り替え、処理の検証、手作業への復帰が必要になります。これは想定される事業継続上のシナリオであり、源内でそのような遮断が発生したという意味ではありません。
「開かれたAI主権」は、すべてを国産化するという意味ではない
人工知能基本計画が掲げたのは、戦略的自律性と戦略的不可欠性を確保する「開かれたAI主権」です。国際的な技術協力や分業、相互運用性を維持しながら、行政、防衛、重要インフラ等の分野で、自ら必要なAIを選択・運用し続ける能力を確保する考え方です。
自律性とは、国や事業者の事情だけで必要な機能を失わないよう、自国側に技術・運用・調達の選択肢を持つことです。不可欠性とは、半導体製造装置、素材、通信、現場データなど、日本の強みをAIの国際的な供給網で生かし、協力相手にとっても重要な役割を担うことを指します。
国産モデルを使うことは一つの手段ですが、それだけで主権が完成するわけではありません。国内製のモデルでも海外の計算資源や更新基盤に強く依存すれば、その部分に供給リスクが残ります。反対に、海外の優れたモデルを利用していても、データの管理、運用停止、監査、切り替えの権限を確保する構成は可能です。
国家安全保障の観点――AIを止められても行政機能を維持できるか
国際情勢による提供停止や技術制限に備える
AIサービスには、クラウド、基盤モデル、GPU、ネットワーク、API、認証基盤など複数の供給者が関係します。国際情勢や輸出管理、提供条件の変更、サービス障害、事業者の撤退などが起きた場合、その一部が使えなくなる可能性があります。
源内基準は、特定事業者や基盤モデルへの過度な依存によって、サービス停止、価格上昇、国際情勢の変化などの影響を受けるリスクを明記しています。その対策として、クラウド、モデル、データ、認証、AIアプリ、RAG、ログ、権限管理などをできるだけ独立させた「疎結合構成」を採用し、標準化されたAPIや共通データ形式で他の構成へ移行できることを目指します。
安全保障上の利点は、ある事業者を排除することではなく、特定の提供者が利用できなくなっても政府側に選択肢が残ることです。ただし、設計上切り替えられることと、非常時に同等の性能・処理量で直ちに運用できることは別です。代替モデルの性能検証、必要なGPU資源、認証・権限設定、職員の手作業への切り戻しまで平時に確認する必要があります。
行政データを外国の法制度・運用条件だけに委ねない
政府の生成AIには、公表前の政策資料、契約や調達に関する文書、行政機関の内部資料などが入力される可能性があります。入力した情報がどこで推論され、どこに保存され、どの主体が管理者権限を持つかは、情報保全上の基本事項です。
源内基準は原則として、国内のガバメントクラウド内で推論処理とデータ保存を行い、プロンプトや添付ファイル、AIの出力をモデル提供事業者の学習・性能改善に利用しないことを契約で確保する方針です。これにより、各府省庁が個別に一般向け生成AIを利用する場合と比べ、データの保存・アクセス・監査について政府共通の管理条件を設定できます。
もっとも、国内データセンターに置くだけで情報が保護されるわけではありません。暗号鍵の管理主体、特権アクセス、バックアップ、ログの保存先、外部サポートからのアクセス権限、委託契約、システム更新経路まで確認が必要です。「国内保管」と「政府が実効的な統制権を持つこと」は区別されます。
AIエージェントを通じた情報操作と不正指示にも対処する
AIエージェントは、検索したWebページ、添付文書、共有されたスキルなど、信頼性の異なる情報を一連の処理に取り込みます。外部資料に悪意ある指示が埋め込まれていた場合、AIがそれを利用者の命令と誤認し、想定外の処理を行う「間接的プロンプトインジェクション」のリスクがあります。
米国NISTも、攻撃者がAIエージェントの参照データに指示を混入させ、意図しない行動を引き起こす「エージェントハイジャック」を評価対象としています。行政でこの問題が深刻になるのは、AIが文章を誤読するだけでなく、許可された権限の範囲内で誤ったファイル操作やデータ処理を実行し得るためです。
源内では、エージェントチャットの作業領域を利用者本人のマイドライブに限定し、アップロードされた原本の上書き・改変を制限するなどの対策を設けています。源内工房では、利用権限を管理者が付与し、外部へのPOST・PUT通信を遮断して操作を記録する設計です。こうした措置は危険性を下げますが、すべての不正指示を検知する保証ではありません。外部通信の制御とあわせ、読み込み元の信頼性、権限の最小化、実行内容の記録、重要操作の人手承認が必要になります。
国家安全保障に使う高機密システムとは分けて考える
人工知能基本計画は、行政に加え防衛・重要インフラをAI主権の戦略領域として挙げています。ただし、それは源内が防衛上のすべての機密情報を扱う基盤になったことを意味しません。
源内基準は、各府省庁等が定める条件の下で機密性2情報を扱うことが可能な環境を示しています。一方、政府が検討する「高機密ソブリンクラウド(仮)」は、さらに高い情報保全・秘密保全要件を想定した別の政策課題です。情報の機密区分に応じ、利用するモデル、閉域性、管理者、通信、監査、調達契約をそれぞれ設計する必要があります。
セキュリティ対策Labでは過去に「日本政府、高機密情報向け『ソブリンクラウド』導入へ」で、その検討背景と米英の取り組みを整理しています。
経済安全保障の観点――国内でAIを選び、育て、使い続ける能力
1.特定モデル・クラウドへの依存を減らし、調達交渉力を持つ
政府全体で数十万人規模にAI利用が広がると、モデル利用料、データ保存料、推論に必要な計算資源などが継続的な調達対象となります。特定モデルしか使えない仕組みでは、値上げや契約条件の変更があっても、移行コストが高いため別の事業者を選びにくくなります。
源内基準は、利用料金だけでなく精度・安全性・業務適合性を比較してモデルを選定し、平時から代替候補や移行手順を検証する方針です。これはサイバー攻撃からの防御にとどまらず、政府が調達において複数の選択肢を保つための施策でもあります。
ただし、モデルを切り替えるだけでコスト削減や安定供給が確約されるわけではありません。再評価、アプリの修正、回答品質の違い、データ移行費用を含めた実際の移行可能性が判断材料になります。
2.国内の計算資源・モデル開発能力を維持する
基盤モデルの開発・運用には、GPUなどの半導体、データセンター、電力、通信、人材が必要です。自国内で利用できる計算基盤やモデルの選択肢が少なければ、急激な需要増や供給網の混乱が起きたときに、行政・企業がAI利用を継続する能力にも影響します。
デジタル庁は2026年、国産クラウド「さくらのクラウド」で、NTTデータの「tsuzumi 2」、富士通の「Takane 32B」、Preferred Networksの「PLaMo 2.0 Prime」を試用する方針を示しました。源内で利用する他のモデルとの比較試験を通じて、性能、信頼性、経済性などを評価する計画です。
これらの試用は、源内全体を国産製品に置き換えたという意味ではありません。国内でもモデルと計算基盤を開発・運用できる選択肢を確保し、政府が実際に使って評価する点に意味があります。
3.政府調達が国産AIの評価と改善の循環をつくる
高度なAIモデルを国内で開発しても、実務で使われなければ改善に必要な利用実績やフィードバックが蓄積しにくくなります。デジタル庁は国産AI試用の狙いとして、政府による安全な利用、行政現場からのフィードバック、政府調達を通じた安定需要の創出を挙げています。
この仕組みでは、政府が国内モデルを無条件に優先するのではなく、海外モデルを含めて評価し、必要な能力や費用対効果を確認することが前提になります。実運用に耐える品質を測り、その改善結果が民間利用へ展開されることで、国内の研究開発や投資に波及する余地があります。
経済産業省とNEDOの「GENIAC」も、国内の基盤モデル開発に必要な計算資源の確保やデータ整備、研究開発を支援しています。2026年6月には第4期の基盤モデル開発テーマ16件を採択しました。源内による利用側の評価と、GENIACによる開発側の能力強化は役割が異なりますが、国内のAIエコシステムを厚くするという方向では重なります。
4.日本の行政・産業データを生かせる選択肢を持つ
日本語の法令、公用文、行政手続き、製造現場の文書や専門用語には、一般的なインターネット上の文章だけでは対応しにくい領域があります。人工知能基本計画は、日本の強みを生かす領域として「バーティカルAI(分野特化型AI)」と「フィジカルAI(現実世界の機械・設備と連携するAI)」を掲げています。
官民が保有する非公開の業務データや産業データを安全に活用できれば、行政や製造業、医療、重要インフラなどの実務に適したAIの開発・評価につながります。ただし、機密データを国内モデルの学習に自由に提供してよいという意味ではありません。目的、権限、個人情報・営業秘密の保護、契約上の学習利用禁止などを区別する必要があります。
経済産業省は2026年5月と7月のGENIAC関連発表でも、企業・組織の実データをAI活用につなげるための「AI-Ready化」を政策課題として挙げています。データを国内で保有していることだけでなく、権利を守りながら安全に利用できる仕組みを整えることが、技術開発上の競争力にも関わります。
5.行政の開発・運用ノウハウを政府内に残す
源内基準は、行政実務に特化したAIアプリをデジタル庁職員が主体的に内製する方針を示しています。職員が法令、政策、国会、調達などの実務知識を反映し、試作から改善までを行うことで、技術や運用ノウハウを政府組織内に蓄積する狙いがあります。
外部事業者への委託自体が問題なのではありません。必要なシステム仕様や品質基準を政府が理解し、障害や不適切な動作が発生した際に、原因を判断し改善を指示できる能力を持ち続けられるかが焦点です。高度なAIの調達先を複数確保していても、行政側に評価・設計・運用できる人材がいなければ、実効的な主権は限定されます。
ソブリンAIがもたらす利点と、導入しても残る課題
ソブリンAIの導入効果は「国産であるか」だけでは評価できません。少なくとも、政府・企業が何を自ら管理できるようになるか、障害や供給停止時に何を継続できるかで確認する必要があります。
| 観点 | 期待できる効果 | 残る課題・確認事項 |
|---|---|---|
| データ保護 | 推論先・保存先・学習利用条件を統制しやすい | 特権管理者、暗号鍵、ログ、委託先のアクセス管理 |
| 国家安全保障 | 提供停止・国際情勢の変化に備えた利用継続手段を確保 | 代替モデルの実力、GPU・電力・ネットワークの供給 |
| 経済安全保障 | 国内モデル・基盤の開発と政府調達による評価機会を確保 | 品質、価格競争力、長期的な研究開発費用 |
| 調達・事業継続 | 特定ベンダーの値上げ・契約変更に対する選択肢を維持 | 移行費用、アプリ互換性、データ移行、切替訓練 |
| セキュリティ運用 | 操作ログ、アクセス権限、通信先を共通方針で管理 | プロンプトインジェクション、内部不正、設定不備 |
| 人材・技術基盤 | 行政側に評価・開発・運用の知見を蓄積 | 人材確保、継続的な訓練、属人化の防止 |
国産AIであれば常に安全だとか、国外のモデルであれば利用できないという結論にはなりません。モデルや事業者の出自と、実際のセキュリティ品質は別の評価軸です。データを国内に保存していても、設定ミスや過大なアクセス権限、不適切なデータ連携による事故は起こり得ます。
また、政府内にAI基盤を共通化することで管理を集約できる一方、共通基盤に障害が起きた場合の影響範囲が広がる可能性もあります。複数リージョン・系統への分散、代替モデル、復旧訓練、利用停止手順、障害時の手作業など、集中管理と可用性の両方を設計する必要があります。
「源内=国産AIのみ、全処理が国内完結」ではない
源内は国産モデルと海外モデルを組み合わせて評価する政府共通環境です。デジタル庁は2026年8月更新の資料で、国内の「さくらのクラウド」と国産モデルの組み合わせを説明するとともに、それ以外のガバメントクラウドや基盤モデルを利用する構成も示しています。
源内基準では原則として、ガバメントクラウド上で動作し、その内部で推論するモデルを利用します。ただし、国内リージョンで提供されていない高度なモデルが必要な場合などには、海外データセンターでの推論を例外的に認めます。その場合は、推論終了後に入力・出力データを海外に保存しないことを契約で確保し、利用者・管理者にリスクと留意事項を説明する方針です。
したがって、源内の全処理が必ず国内で完結するという説明は正確ではありません。行政機関が実際に利用する際は、対象業務の情報区分、利用モデル、処理国、保存国、学習への使用可否、契約条件を確認する必要があります。
こうした例外を一定の条件下で設けることは、性能や業務適合性の高い海外モデルを活用するための選択肢でもあります。一方で、主権性の実効性は例外利用の管理、監査、切り替え可能性まで含めて評価されます。
過去の源内展開・高機密ソブリンクラウドとの関係
源内の政府横断展開は今回初めて発表されたものではありません。デジタル庁は2026年5月に大規模実証を開始し、同年度中に約18万人へ利用可能な範囲を拡大する計画を示してきました。今回の新機能は、既存の生成AI利用環境をさらに実務へ組み込むための拡張です。
セキュリティ対策Labでは、8月21日付の記事「日本政府、ガバメントAI『源内』、政府職員18万人へ」で、国会答弁作成支援や米国・英国・EUの政府AIの取り組みを比較しました。また、8月17日付の記事「日本政府、高機密情報向け『ソブリンクラウド』導入へ」では、政府が検討する高機密クラウドとデータ主権の課題を取り上げています。
今回の「源内基準」は、従来のAI利用ルールをAIエージェントの実行権限や通信制限、モデル切り替えの設計まで広げたものです。政府のAI活用が進むにつれ、行政の効率化と同時に、業務の継続性、供給網の自律性、情報保全を一体として管理する必要性が高まっています。
企業の情報システム部門が確認したいAI主権と運用上のポイント
政府機関と企業では保有情報の性質や法的義務は異なります。ただし、AIエージェントを社内のファイルサーバー、CRM、メール、開発基盤などにつなげる場合、源内基準が示す統制の考え方は参考になります。
- 情報の分類と処理先:顧客情報、営業秘密、ソースコード、脆弱性診断結果など、情報区分ごとに使用可能なモデル・保存先・推論先を決める。
- 管理者と権限の所在:AIに付与する認証情報やツール権限を棚卸しし、利用者本人の権限を超える操作を認めない。
- 外部送信と承認:外部サイトの閲覧、API接続、ファイル更新、公開、削除などを分け、影響の大きい処理は人が承認する。
- モデル・クラウドの代替性:障害・値上げ・契約終了時に、必要なデータとアプリを別環境へ移せるか実地に確認する。
- 監査ログと復旧:誰がどのAIを使い、どのデータを読み、何を実行したかを追跡できるようにし、誤処理から復元できる手段を用意する。
- モデル評価と人材:モデルを国籍だけで選ばず、セキュリティ、性能、費用、法令・業務適合性、運用できる社内人材の有無を検証する。
詳しいAI固有のリスクや基本的な管理策については、「AIセキュリティとは?生成AIのリスクと対策」でも整理しています。
AIが業務システムを扱う範囲を広げるほど、企業や行政機関が問われるのは「高性能なモデルを使えるか」だけではなくなります。重要な情報を統制できるか、AIが意図しない行動を取った際に止められるか、サービスが利用できなくなっても事業を継続できるか。ソブリンAIは、そうした実務上の統制能力を支える設計方針として捉える必要があります。
出典
- ガバメントAI 源内においてAIエージェント利用環境の提供を開始するとともに、「源内基準」を公表します – デジタル庁
- ガバメントAI 源内 ガバナンス・セキュリティ・セーフティに関する基準(第1版、2026年10月) – デジタル庁
- ガバメントAI 源内における「AIエージェント」利用環境の導入 – デジタル庁
- 人工知能基本計画(2026年7月14日閣議決定) – 内閣府
- ガバメントAI 源内における国産クラウド上での国産基盤モデルの試用開始について – デジタル庁
- 全府省庁の約18万人の政府職員を対象としたガバメントAI(源内)の大規模実証を開始しました – デジタル庁
- 「GENIAC」における計算資源の提供支援(第4期)において、AI基盤モデル開発テーマ計16件を採択しました – 経済産業省
- GENIACにおいて製造業データ等のAI-Ready化に関する研究開発テーマを採択 – 経済産業省
- GENIACにおいてデータエコシステム構築等に関する研究開発テーマを採択 – 経済産業省
- Strengthening AI Agent Hijacking Evaluations – NIST
関連記事
 FortiOSの修正済み 脆弱性 CVE-2025-25249がサイバー攻撃に悪用、PivotC2を展開 CISA KEVに追加
 Ivanti Neurons for ITSMに8件の脆弱性、EPMMにも権限昇格 未認証RCEを含む9件を修正(CVE-2026-12744,CVE-2026-12745)他
 中国で複数の邦人拘束が判明、当局への聴取協力のため入国後に拘束された例も レアアース輸出規制の執行強化が生む新たなリスク
 Insecamとは 世界のWEBカメラ/監視カメラを閲覧できるサイト
 サイバー攻撃集団 ロックビット(LockBit)とは?
 I-SOON 中国政府へサイバー攻撃 ツールを提供していた企業から内部リーク
 Hugging FaceでAIのバックドア 付き 機械学習モデルを確認
 ChatGPTやGeminiなどの文章生成AIで拡散するマルウェア Morris II を研究者が発表
 AIや生成AIの悪用事例や事件を解説

