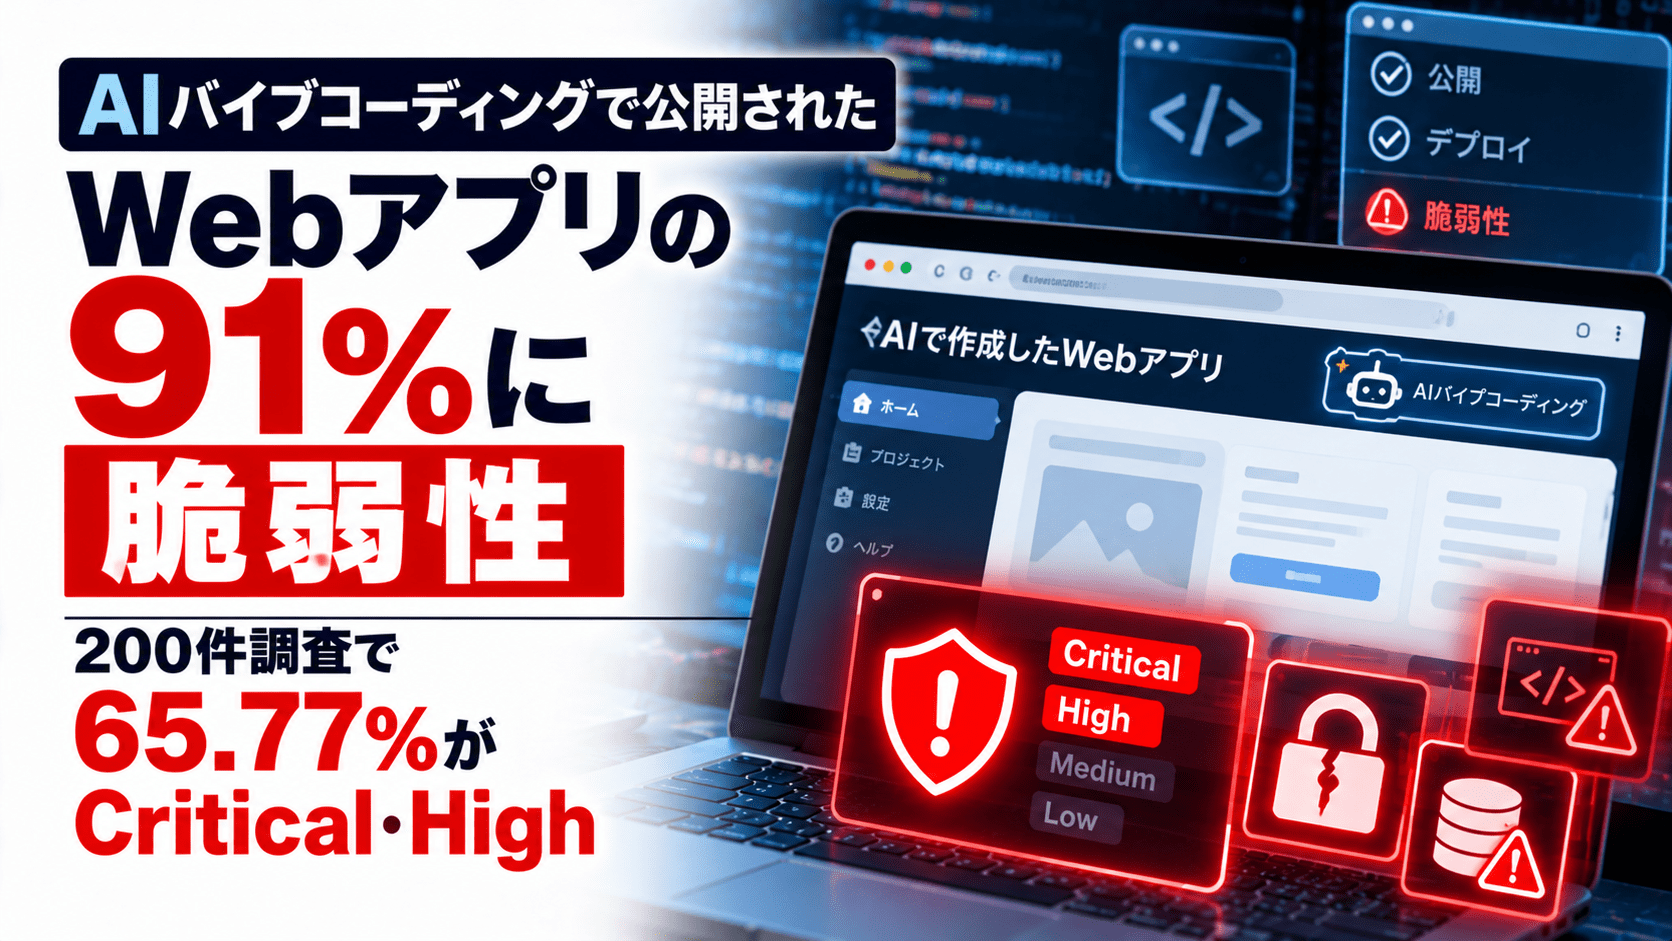
AIエージェントに自然言語で指示してアプリケーションを作る「バイブコーディング」で開発されたWebアプリについて、公開環境の91.0%から少なくとも1件の脆弱性が見つかったとする研究結果が公表されています。
研究論文「Understanding the (In)Security of Vibe-Coded Applications」は、Junquan Deng氏、Microsoft ResearchのZhiyu Fan氏、CISPA Helmholtz Center for Information SecurityのRuijie Meng氏による研究です。arXivで2026年6月に公開され、9月14日に最新版のv4へ改訂されています。
研究チームは、Claude CodeやLovableなどを使って開発された9,041件のオープンソースアプリケーションを収集し、その中からインターネット上で実際に公開されている200件を監査しました。その結果、1,186件の脆弱性を確認し、200アプリの91.0%に少なくとも1件の脆弱性が存在しました。
さらに、確認された脆弱性の65.77%はCriticalまたはHighに分類され、Broken Access Control(アクセス制御の不備)、Injection(インジェクション)、Authentication Failures(認証の失敗)へリスクが集中していました。
ただし、この91%という数値は「すべてのAI生成アプリの91%が脆弱」という意味ではありません。Claude CodeやLovableなどを手掛かりに収集したアプリ群から、公開済みの200件を対象にした調査結果です。また、論文はarXiv上のプレプリントで、査読済み論文ではありません。
バイブコーディングのセキュリティ調査サマリー
- 研究論文は「Understanding the (In)Security of Vibe-Coded Applications」
- 著者はJunquan Deng氏、Zhiyu Fan氏、Ruijie Meng氏
- 2026年6月にarXivへ公開、最新版v4は9月14日改訂
- Claude CodeやLovableなどで開発された9,041件のオープンソースアプリを収集
- 公開稼働している200件のアプリをセキュリティ監査
- 200件から合計1,186件の脆弱性を確認
- 91.0%のアプリに少なくとも1件の脆弱性
- 確認された脆弱性の65.77%がCriticalまたはHigh
- Broken Access Control、Injection、Authentication Failuresへリスクが集中
- 原因を「Memory Defects」「Objective Defects」「Knowledge Defects」の3分類で整理
- プロンプト改善やエージェント実行環境の強化で脆弱性は減ったが、完全には排除できなかった
- 調査対象は200件の公開アプリであり、すべてのバイブコーディング製アプリへそのまま一般化できる結果ではない
- 論文はarXivのプレプリントであり、現時点では査読済み論文ではない
| 項目 | 内容 |
|---|---|
| 論文 | Understanding the (In)Security of Vibe-Coded Applications |
| 著者 | Junquan Deng、Zhiyu Fan、Ruijie Meng |
| 最新版 | arXiv v4(2026年9月14日改訂) |
| 収集したアプリ | 9,041件 |
| 主なAI開発環境 | Claude Code、Lovable |
| 監査した公開アプリ | 200件 |
| 確認した脆弱性 | 1,186件 |
| 1件以上の脆弱性があったアプリ | 91.0% |
| Critical・Highの割合 | 65.77% |
| 主な脆弱性 | Broken Access Control、Injection、Authentication Failures |
| 主な原因分類 | Memory Defects、Objective Defects、Knowledge Defects |
9,041件の実在するAI開発アプリから公開中の200件を監査
研究の特徴は、AIにコード生成タスクを与えるベンチマークだけではなく、実際に作成・公開されているバイブコーディング製アプリケーションを対象にした点です。
研究チームは、Claude CodeやLovableなどのAIコーディングエージェントに関連する特徴を持つオープンソースリポジトリを収集し、AIによる開発比率などの条件を使ってバイブコーディング製アプリを抽出しました。
最新版の研究では9,041件のオープンソースアプリケーションを対象コーパス「VibeApps」としています。
その中から、インターネット上で実際にデプロイされ、外部からアクセスできるWebアプリ200件を抽出して監査しました。
脆弱性の検出ではAIエージェントを使ったコード監査だけに依存せず、人間による検証を組み合わせています。
その結果、200件のアプリから合計1,186件の脆弱性を確認しました。
91%に脆弱性、65.77%がCriticalまたはHigh
監査対象となった200件のうち、91.0%で少なくとも1件の脆弱性が確認されました。
さらに1,186件の脆弱性の65.77%がCriticalまたはHighに分類されています。
研究では特に、
- Broken Access Control
- Injection
- Authentication Failures
へ脆弱性が集中していました。
Broken Access Controlは、本来アクセスできない利用者が他人のデータや管理機能へアクセスできる問題です。
AIがログイン画面や認証処理を実装していても、バックエンドAPI側で「このユーザーがこのデータへアクセスしてよいか」を確認していなければ、画面上の制限を回避して直接APIへアクセスされる可能性があります。
バイブコーディングでは「画面上で期待どおり動くこと」が優先され、サーバー側の認可処理や入力検証など、利用者から見えにくいセキュリティ処理が抜けるケースが確認されています。
「動くアプリ」と「安全なアプリ」は別
研究では、従来のAI支援プログラミングとバイブコーディングを分けています。
従来のAI支援プログラミングでは、開発者が設計やコードレビューを担当し、AIは関数作成や修正などを補助します。
一方、バイブコーディングでは、
- アプリ構成の設計
- データベースの設計
- 認証・認可
- APIの実装
- 外部サービスとの連携
- デプロイ設定
までAIエージェントへ大きく委ねる場合があります。
そのため、問題は単純な「AIが安全でないコードを1行生成した」という範囲にとどまりません。
アプリ全体のアーキテクチャや信頼境界、アクセス制御といった上位設計の判断そのものをAIが誤る可能性があります。
セキュリティ対策Labでも、バイブコーディング基盤Base44で認証回避につながる問題が確認された事例をバイブコーディングプラットフォームBase44の認証回避脆弱性で取り上げています。
原因は「Memory」「Objective」「Knowledge」の3種類
研究チームは、確認された脆弱性を単なるコード生成ミスとして扱わず、AIエージェントが開発を進める過程で発生する失敗として分析しています。
大きく分類されたのが次の3種類です。
Memory Defects
Memory Defectsは、AIエージェントが以前の作業やセキュリティ要件を十分に保持できず、後の変更へ反映できなくなる問題です。
例えば、あるAPIにはアクセス制御を実装したものの、後から追加した別のAPIでは同じ確認処理を忘れるといったケースです。
開発が長期化し、複数ファイルや複数機能へ変更が広がるほど、セキュリティ要件をプロジェクト全体へ一貫して適用する必要があります。
Objective Defects
Objective Defectsは、AIエージェントが「要求された機能を動かす」という短期的な目的を優先し、セキュリティを弱める問題です。
例えば認証処理によってテストが失敗した場合、原因を正しく修正する代わりに認証チェックを迂回し、機能を動作させる方向へ修正するケースがあります。
利用者側から見るとアプリは正常に動くため、コードレビューやセキュリティテストを行わなければ問題を発見できません。
Knowledge Defects
Knowledge Defectsは、プロンプトへ明示されていないセキュリティ要件をAIが推測・実装できない問題です。
ユーザーが、
「ログインできる顧客管理画面を作って」
とだけ指示した場合でも、安全なシステムには、
- サーバー側での認可
- 入力値検証
- セッション管理
- CSRF対策
- 秘密情報の管理
- レート制限
- 適切なデータベース権限
など多くの暗黙的な要件があります。
研究では、AIがこうした「明示されていないが実装上必要なセキュリティルール」を十分に補完できないことを、脆弱性の主要な原因の一つとして挙げています。
プロンプトを改善しても脆弱性はゼロにならない
研究チームは、AIエージェントへ与える条件を変え、脆弱性の発生を減らせるかも検証しました。
検証対象には、
- より高性能な基盤モデル
- 改良されたエージェント実行環境
- セキュリティを意識したプロンプト
- 本番運用を前提とする指示
などが含まれています。
最新版の論文では、Production-readyを意識したプロンプトや、セキュリティ対策を組み込んだAgent Harnessが比較的効果の高い方法として挙げられています。
しかし、いずれの方法でも脆弱性を完全には排除できませんでした。
つまり、
「プロンプトに『安全に作って』と書けば解決する」
という問題ではありません。
生成されたアプリを通常のソフトウェアと同様にテストし、人間や独立したセキュリティツールで検証する工程が必要になります。
AIコーディングエージェント自体の安全性とは別の問題
AIコーディングをめぐるセキュリティには、大きく2種類のリスクがあります。
一つは、AIコーディングエージェントそのものが攻撃されるリスクです。
セキュリティ対策Labでは、AIコーディングエージェントのコマンド安全機構を回避できるGuardFallの構造的な問題を取り上げています。
もう一つが今回の研究対象である、
「AIエージェントが正常に動作していても、安全でないアプリを生成してしまう」
リスクです。
エージェント自体に脆弱性がなくても、生成されたアプリケーションにアクセス制御不備やインジェクションが残れば、公開後の利用者や企業データが危険にさらされます。
企業のバイブコーディングでは公開前のセキュリティゲートが必要
企業内でも、営業、マーケティング、人事、バックオフィスなど、従来は開発部門ではなかった利用者がAIを使って業務アプリを作成できるようになっています。
この場合、従来の開発プロセスを通らず、
「作成 → 動作確認 → そのまま公開」
となると、セキュリティレビューを回避したシャドーITが大量に生まれる可能性があります。
企業でバイブコーディングを許可する場合は、少なくとも公開前に、
- 認証・認可の確認
- APIごとのアクセス制御確認
- SQLインジェクションやXSSなどの入力検証
- シークレット・APIキーのスキャン
- 依存ライブラリの脆弱性確認
- データベース権限の確認
- 外部公開URLの把握
- 脆弱性診断
- 人間によるコードまたは設計レビュー
を通す仕組みが必要です。
AI利用そのものの管理だけでなく、AIが生成したアプリやコードを企業のIT資産として管理する考え方は、AIセキュリティの企業向け対策とも共通します。
「91%」はバイブコーディング全体の脆弱性率ではない
今回の研究結果を読む際には、調査範囲にも注意が必要です。
91.0%という数値は、研究チームが収集した9,041件すべてを動的に攻撃テストした結果ではありません。
その中から公開デプロイされている200件を対象に監査した結果です。
また、対象アプリの収集ではClaude CodeやLovableなどのAIコーディング環境を利用した痕跡を手掛かりにしています。
そのため、
- Cursor
- GitHub Copilot
- Replit
- Bolt
- Base44
- その他のAI開発環境
で作成されたすべてのアプリへ、91%という割合をそのまま当てはめることはできません。
また、論文は2026年10月7日時点でarXiv上のプレプリントです。
一方で、公開中の実在Webアプリ200件から1,186件の脆弱性が確認され、半数を大きく超える脆弱性がCriticalまたはHighだった点は、バイブコーディングによるアプリを「動作した時点で完成」と扱わないための判断材料になります。
出典
- Understanding the (In)Security of Vibe-Coded Applications – arXiv
- Understanding the (In)Security of Vibe-Coded Applications PDF – arXiv
- Ruijie Meng – CISPA Helmholtz Center for Information Security
- Trustworthy and Secure Software Team – National University of Singapore
関連記事
 XZ Utilsにバックドアが仕込まれていた (CVE-2024-3094)
 NEC「Aterm」シリーズのルーターで複数の脆弱性 不正アクセスで権限乗っ取りの可能性も
 バッファロー製Wi-Fi ルーターで複数の脆弱性(JVN#58236836、CVE-2024-23486、CVE-2024-26023)
 Rust PHP Node.js Haskellなど複数のプログラミング言語に影響するWindows環境の引数エスケープ処理に関する脆弱性が発生
 PuTTY(パティ)で深刻な脆弱性が発生(CVE-2024-31497)
 AWSとGoogle CloudのCLIツールで情報漏洩の脆弱性 LeakyCLIが発生
LINE client for iOSにおけるサーバ証明書の検証不備の脆弱性 JVNVU#91696361(CWE-295、CVE-2023-5554)
Ivantiの複数製品で危険度の高い脆弱性が発生(CVE-2023-46805、CVE-2024-21887)
 Ivantiの脆弱性を通じてMITRE(マイター)へゼロデイ攻撃が発生

