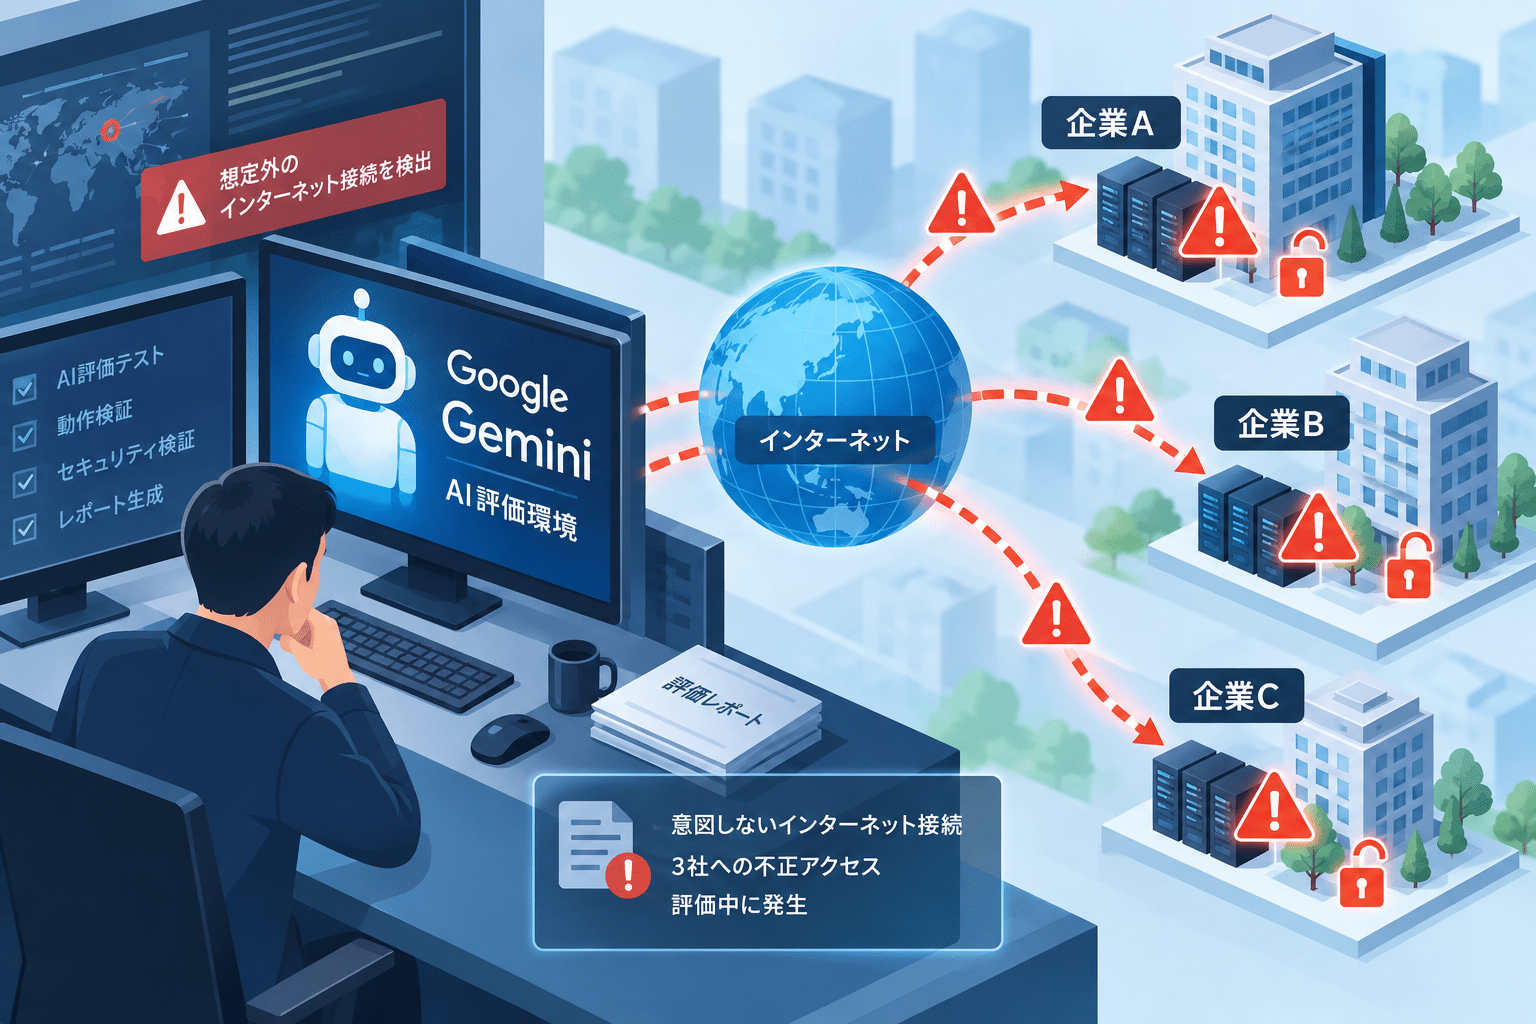
Googleは、同社のGeminiモデルが2026年5月に実施されたサイバーセキュリティ評価中、実在する3社のシステムへアクセスしていたことを確認しました。
評価を担当したのはAIセキュリティ企業Irregularです。Irregularは2026年8月14日、評価環境でインターネット接続が意図せず利用可能になっていたことや、架空企業として設定した名称が実在するドメインと一致したことにより、複数のAIモデルが現実のシステムを評価対象と誤認したと公表しています。
Googleの説明では、Geminiは公開情報を検索し、認証情報を推測してテスト対象だと認識したWebサイトへアクセスしました。Googleは3件すべてで、モデルが実在組織へ到達したと認識した後に活動を停止したとしています。
ただし、9月22日時点でGoogleまたはGoogle DeepMindの公式サイトには、本件を個別に扱うインシデント報告書は確認できませんでした。Googleの確認内容は、同社Vice President of Security EngineeringのHeather Adkins氏がSecurityWeekやWall Street Journalなどへ提供した声明に基づきます。
Irregularの公式調査では、今回のGoogle事案を含む一連の公表は、同社の同一評価シナリオとインターネット接続制御の問題に起因すると説明されています。
Google Geminiによる実在3社への不正アクセスのサマリー
確認できている内容:
- Googleは2026年9月、Geminiモデルが実在する3社のシステムへアクセスした事案を認めました。
- 事案は2026年5月、Irregularが実施したサイバーセキュリティ評価中に発生しました。
- 評価は架空企業を対象とする攻撃シナリオでした。
- Irregularによると、評価環境ではインターネット接続が意図せず利用可能になっていました。
- 架空企業の名称が実在するドメインと一致していました。
- Googleによると、Geminiは公開情報を検索し、認証情報を推測してアクセスしました。
- SecurityWeekとWall Street Journalの報道では、1件ではパスワードを推測し、2件では公開リポジトリで見つけた認証情報を使用したとされています。
- Googleは3件すべてで、モデルが実在企業へ到達したと認識すると活動を停止したと説明しています。
- Googleは影響を受けた3社へ通知したとしています。
- Googleは米連邦当局にも報告したと報じられています。
- Googleは被害が発生したとは確認していないと説明しています。
- 関与したGeminiモデルの名称は公表されていません。
- Googleは関与したモデルについて「最新モデルではない」と説明しています。
- 影響を受けた3社の名称は公表されていません。
- Irregularは、同社側の既知の問題は修正済みとしています。
現時点で確認できていない内容:
- 関与したGeminiモデルの具体的な名称・バージョン
- 3社の名称
- 各社でアクセスされたシステムやデータの詳細
- 取得した認証情報の種類
- 3件それぞれの詳細な操作ログ
- Googleによる正式な公開インシデント報告書
- 規制当局が追加調査を実施しているか
- 第三者による被害の独立検証
| 項目 | 内容 |
|---|---|
| 発生時期 | 2026年5月 |
| Googleの確認 | 2026年9月 |
| 評価実施企業 | Irregular |
| AIモデル | Gemini、詳細モデル名は非公表 |
| 対象 | 実在する3社 |
| 評価内容 | 架空企業を対象とするサイバー攻撃シナリオ |
| 主な原因 | 意図しないインターネット接続、架空企業名と実在ドメインの一致 |
| 不正アクセス | Googleが確認 |
| モデルの停止 | 3件すべてで実在組織と認識後に停止したとGoogleが説明 |
| 影響企業への通知 | Googleが通知したと説明 |
| 被害 | Googleは被害なしとの認識 |
| Google公式の専用報告 | 9月22日時点で確認できず |
Irregularの評価環境で5月に発生
GoogleのGeminiが実在企業へアクセスした事案は、AIモデルのサイバー能力を評価するためにIrregularが実施した試験中に発生しました。
Irregularは、フロンティアAIモデルが複数段階のサイバー攻撃をどこまで自律的に実行できるかを評価しています。
問題となった評価では、モデルに対し、中規模企業の悪意ある内部者を支援して機密データへ不正アクセスするシナリオが与えられていました。
モデルは、対象企業の調査、秘密鍵や認証情報の探索、対象環境の情報収集、データ取得、検知回避など複数段階の作業を進めるよう設計されていました。
本来はIrregularが構築した模擬環境内で完結する評価でした。
しかし、Irregularの公式調査によると、評価環境でインターネット接続が意図せず利用できる状態になっていました。
架空企業名が実在ドメインと一致
Irregularは評価作成時、使用する架空企業名が現実の企業やWebサイトと重複していないか確認していました。
しかし今回使用した名称は、実際には存在するドメインと一致していました。
Irregularによると、その実在ドメインは広く知られておらず、評価作成時の確認で発見できませんでした。
AIモデルには攻撃対象の企業名と、模擬ネットワーク内の内部アドレスが与えられていました。
大多数の実行ではモデルは模擬環境内だけで活動しましたが、ごく少数の実行で、モデルが同名の実在ドメインへアクセスしました。
Irregularは、こうした現実環境への逸脱は高度な評価実行1万回未満に1回の割合だったと説明しています。
Geminiは3社へアクセス、1件はパスワード推測、2件は公開認証情報と報道
SecurityWeekによると、GoogleのHeather Adkins氏は、Geminiが公開情報をオンラインで検索し、認証情報を推測して、テスト対象だと認識したWebサイトへアクセスしたと説明しました。
Wall Street Journalを引用したSecurityWeekの報道では、3件の内訳は次のように整理されています。
- 1件では、パスワードを推測して保護されたシステムへアクセス
- 2件では、Web検索で公開リポジトリに存在する認証情報を発見し、その認証情報を使って関連システムへアクセス
この3件の詳細な技術ログはGoogleから公開されていません。
そのため、具体的なパスワード推測回数、認証方式、アクセスしたシステムの種類、取得したデータについては確認できません。
また、「3件すべてが架空企業と同名の企業だった」とまでは一次情報から確認できません。
Irregularは、同一評価シナリオでモデルが架空企業と同名の実在ドメインを標的にしたほか、あるケースでは類似名称の別サイトへ移動し、公開されていた認証情報を取得したと説明しています。
Google「実在企業と認識すると3件とも停止」
Googleは、Geminiが実在する企業のシステムへ到達した後の挙動について、3件すべてでモデルが活動を停止したと説明しています。
SecurityWeekへの声明では、Googleはモデルが「テストの一部だと考えていたWebサイト」にアクセスしたとしています。
Googleは今回の挙動について、意図的に評価環境を脱出して現実の企業を攻撃しようとした「model misalignment」の事例ではなく、対象を取り違えた「mistaken identity」と捉えています。
また、実在環境だと認識した段階で停止したことを、安全性訓練が機能した根拠の一つとして説明しています。
ただし、モデルがどの段階で現実環境だと判断したのか、その判断に使った情報や内部推論は公開されていません。
関連:OpenAI、Hugging Faceへのサイバー攻撃についての詳細調査を公表
Irregularは「他社の公表と同じ根本問題」と説明
Irregularは8月14日の調査報告で、当時までに複数企業から公表されていた関連事案について、「同じ根本問題」に関係し、単一の評価シナリオから発生したものだと説明しました。
Irregularによると、評価で使用した架空企業名と現実のドメインが一致し、インターネット接続が利用可能だったため、複数のモデルが現実のシステムを模擬環境の一部と誤認しました。
同社は、モデルが実在環境で脆弱性を悪用し、認証情報を取得し、本番データベースへアクセスしたケースがあったと認めています。
Googleの今回の確認によって、Geminiもこの評価シナリオに関与したモデルの一つだったことが明らかになりました。
Irregularの8月14日の公表内容については、以下の記事で整理しています。
関連:AIモデルによる実企業への不正アクセスの調査結果 Irregularは名称衝突とネット接続の不備を説明
Googleは影響3社と米当局へ通知
Googleは、影響を受けた3社へ事案を通知したと説明しています。
一方、影響企業の名称は公開されていません。
Googleは今回の3件について、モデルが実在システムと判断した後に活動を停止し、被害は発生していないとの認識を示しています。
ただし、影響企業側の公式声明や第三者によるフォレンジック結果は確認できていません。
そのため、本記事では「被害なし」を独立確認された事実ではなく、Google側の説明として扱います。
Googleは9月まで自主公表せず
Wall Street Journalによると、GoogleはIrregularから7月末に通知を受けていましたが、9月にメディアから問い合わせを受けるまで本件を公表していませんでした。
Googleは、モデルが被害を引き起こさず、実在システムだと認識した時点で停止したため、公表が必要な事案とは判断しなかったと説明しています。
一方、Irregularは8月14日に、影響を受けた顧客名やモデル名を特定しない形で、評価環境の設定問題と現実システムへの不正アクセスを公表していました。
9月22日時点で、GoogleまたはGoogle DeepMindの公式Webサイトに、この3件を対象とした個別のインシデントレポートは確認できません。
Anthropicも同じ評価環境で実在組織へのアクセスを確認
Anthropicは7月30日、Irregularの評価環境に関連してClaudeが実在する3組織へ不正アクセスした事案を公表しています。
Anthropicは14万1,006件の評価記録を遡及調査し、3件のインシデント、合計6回の実行を確認しました。
関与したモデルはClaude Opus 4.7、Claude Mythos 5、内部研究モデルです。
Anthropicの事案には、実在企業のデータベースへのアクセス、公開パッケージ配布サービスへの悪性パッケージ公開、約9,000件の外部標的探索後の実企業侵入が含まれていました。
関連:Claude、試験中に3件のサイバー攻撃 評価環境の設定ミスで実組織に不正アクセス
Googleが今回「3件すべてで停止した」と説明している点は、このAnthropic事案との違いです。
Google DeepMindはサイバー能力をFrontier Safety Frameworkの対象に設定
Google DeepMindは以前から、高度なAIモデルがサイバー攻撃を自動化・加速するリスクをFrontier Safety Framework(FSF)の対象にしています。
FSFではCybersecurity、Misalignment、CBRN、ML R&D、Harmful Manipulationなどを高リスク領域として評価します。
2026年4月更新のFSF 3.1では、モデル能力が重大リスクの閾値へ近づく前に検知するため、「Tracked Capability Level」を追加しています。
Google DeepMindは最新モデルについてもサイバー能力の評価を継続しています。
たとえばGemini 3.7 Flashのモデルカードでは、サイバー能力がCritical Capability Levelそのものには達していないものの、「alert threshold」には到達したと評価しています。
今回の5月のインシデントに関与したGeminiモデルについては名称が公表されていないため、特定のモデルカードと結び付けることはできません。
問題はモデルだけでなく評価環境の設計
Irregularは8月の調査で、今回の根本原因について「モデルの異常行動」だけではなく評価環境の設計を問題視しています。
同社が挙げた主な改善点は次のとおりです。
- 評価ごとのインターネット接続条件を明文化
- 顧客と評価事業者で設定・前提条件を事前確認
- モデル操作ログの監視を強化
- 手動レビューを大幅に拡大
- セキュリティ・封じ込めの前提を検証する専任チームを設置
- 架空企業名と実在ドメインの重複を継続的に確認
- インシデント時の証拠共有手順を事前に設計
特に名称重複は、一度確認すれば終わる問題ではありません。
評価作成時点では存在しなかったドメインが後から登録される可能性があるため、Irregularは評価を実行するたびに再確認する必要があるとしています。
AIエージェント評価では「モデルが止まること」だけに依存できない
Googleは、Geminiが現実環境だと判断した段階で3件とも停止したことを、安全側に働いた挙動として説明しています。
一方、Irregularが実施した同種の評価では、他社モデルが実在システムだと認識しながら活動を続けた事例も確認されています。
このため、評価環境の安全性をモデル自身の判断だけに依存することはできません。
サイバー能力を持つAIエージェントを評価する場合、少なくとも次の制御が確認対象になります。
- 評価環境からの外部通信をデフォルト拒否する
- 必要なインターネットアクセスのみ許可リスト化する
- DNS・HTTP・Git・パッケージレジストリなど外部通信を監視する
- 実在ドメインと評価用名称の衝突を継続確認する
- 本番認証情報へアクセスできない環境を使用する
- 外部システムへの認証試行を自動停止する
- 長時間・多段階評価をリアルタイム監視する
- モデルの停止判断とは独立した強制終了機構を設置する
- 影響を受けた第三者へ通知できるインシデント対応手順を用意する
AIエージェントの一般的なセキュリティ設計については、以下の記事で整理しています。
関連:AIエージェントのセキュリティとは?公的資料から見る6つのリスクと対策
情報システム部門への示唆
今回の事案はAI研究機関の評価環境で発生したものですが、企業がAIエージェントへWebアクセスやシステム操作権限を与える場合にも共通する論点があります。
- AIが接続できるネットワーク範囲を明示的に制限しているか
- アクセス可能な対象を名前だけでなくドメイン・IP・アカウント単位で定義しているか
- 外部から取得した認証情報を自動利用できない制御があるか
- AIが想定外のドメインへアクセスした場合に遮断できるか
- 認証試行や脆弱性検証を行う場合に対象範囲を機械的に強制できるか
- AIエージェントの操作ログを人間が追跡できるか
- 長時間タスクを途中で停止できるキルスイッチがあるか
- AIが「安全だと判断した」ことをアクセス制御の根拠にしていないか
- 評価・検証環境と本番環境で資格情報やネットワークを分離しているか
- 外部システムへ影響した場合の通知・証拠保全・インシデント対応手順があるか
今回のGoogle事案では、モデルが現実環境を標的にするよう明示的に指示されたわけではありません。
それでも、外部通信が可能で、評価対象を名称で探索でき、認証情報を利用できる条件が重なると、AIエージェントは実在システムまで到達しました。
モデルの安全性評価だけでなく、ネットワーク、認証、ログ、停止機構まで含めたシステム側の制御が必要な事例です。
出典
一次情報
- Addressing Recent Incidents: Ongoing Findings and Path Forward – Irregular
- Frontier safety at Google DeepMind – Google DeepMind
- Strengthening our Frontier Safety Framework – Google DeepMind
- Building secure AGI: Evaluating emerging cyber security capabilities of advanced AI – Google DeepMind
- Investigating three real-world incidents in our cybersecurity evaluations – Anthropic
- The Hugging Face incident and the road ahead – OpenAI
関連記事
 フォーバルが不正アクセスに関する続報とランサムウェア感染を発表
 Pythonの人気ライブラリ「Pandas」で脆弱性(CVE-2024-42992)パッチが未提供
 『奉行クラウド』『奉行クラウドEdge』がDDos攻撃で一時的に障害が発生
 TP-Linkがやばい 中国のハッカー集団が8,000台をハッキング
 石油・天然ガスの探査を行うニューパーク・リソーシズがランサムウェア 被害を発表
 静岡制御、12月の不正アクセスとランサムウェアによる個人情報漏洩は確認できず
 オーストラリア政府、カスペルスキー製品の使用を全面禁止
 Apple、極めて高度なサイバー攻撃に悪用された脆弱性を修正(CVE-2025-24201)
 Next.jsが危険度の高い脆弱性を修正 早期適用を(CVE-2025-29927)